Em poucas palavras
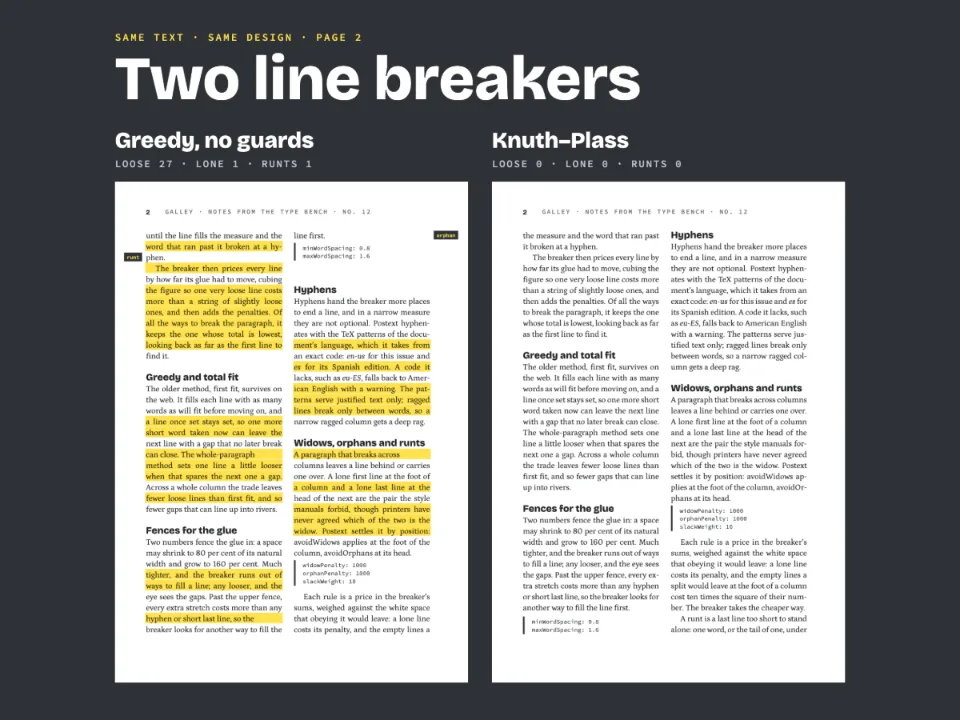
Numa coluna justificada estreita, uma chamada como [2, 3] pode abrir sozinha uma linha, e p < 0,05 pode se partir depois do sinal. O artigo é composto duas vezes: uma mostra onde isso acontece, a outra quase sempre o evita.
O que você vai compor
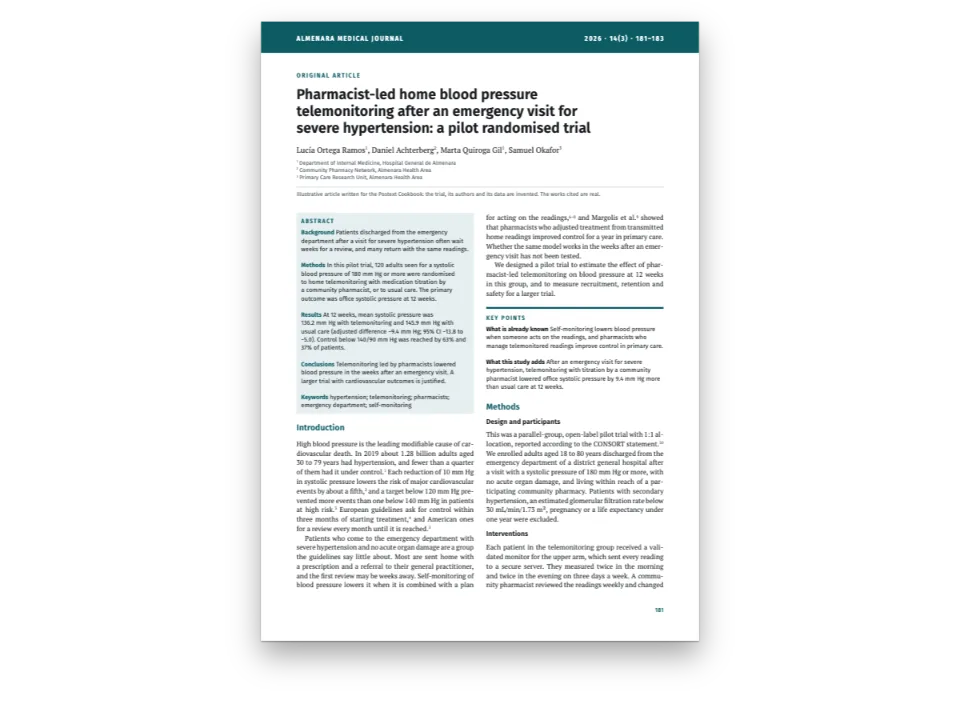
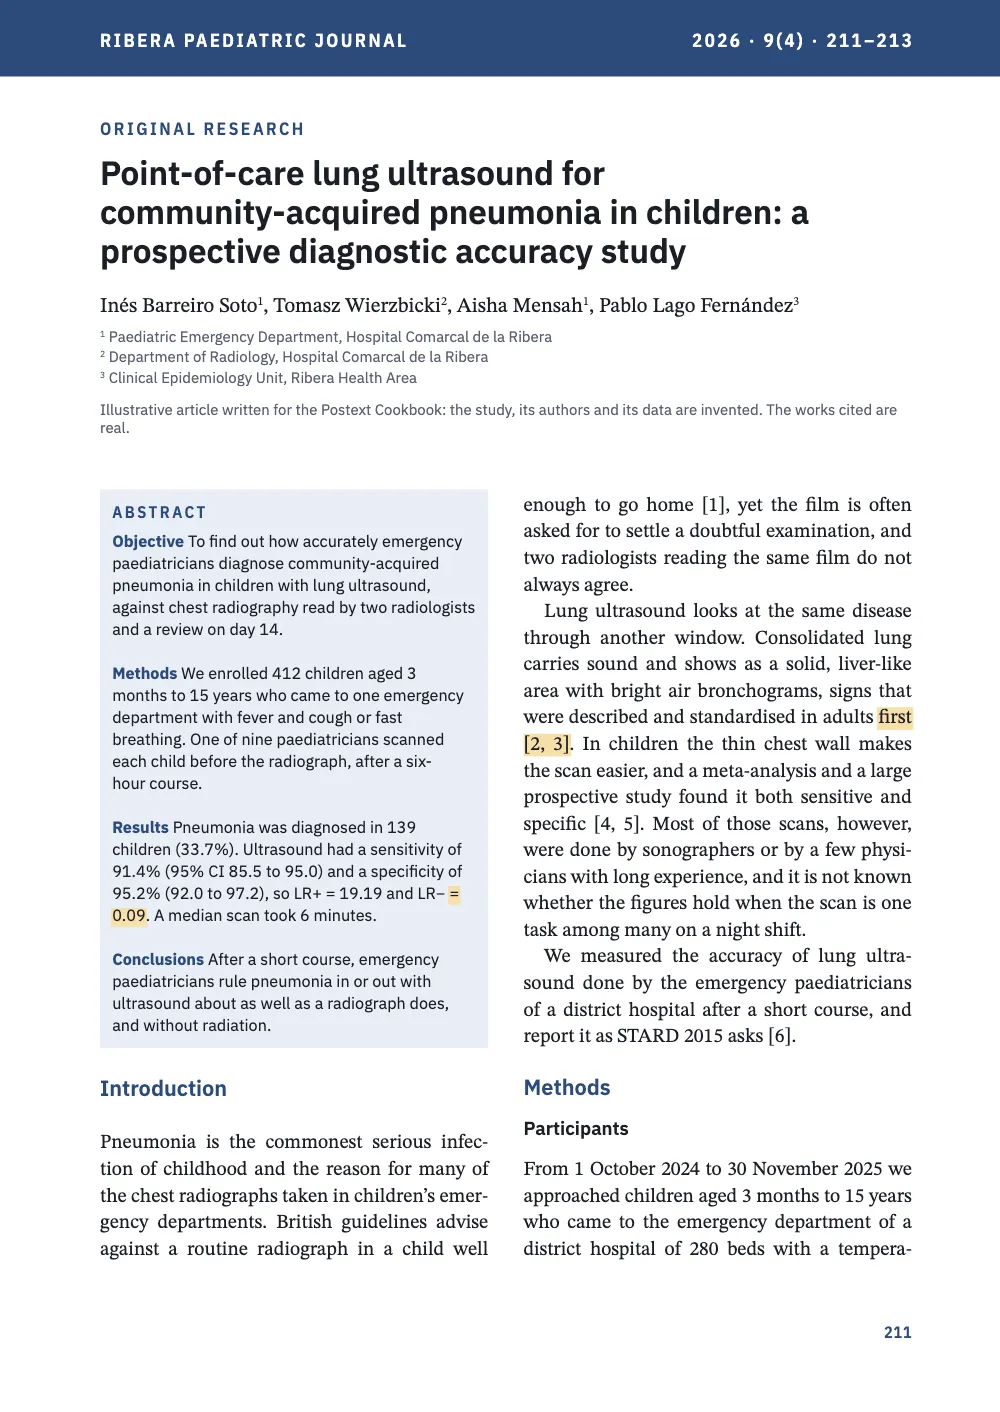
Três páginas de uma revista de pediatria de 170 × 240 mm, em duas colunas justificadas de 66 mm em STIX Two Text: um estudo original sobre ultrassom pulmonar na pneumonia infantil, com referências numeradas no estilo Vancouver. Uma coluna tão estreita deixa poucas saídas para o algoritmo de quebra, e em três lugares o texto em inglês quebra mal. Uma chamada, [2, 3], abre uma linha sozinha, longe da palavra a que se refere, e duas vezes a razão de verossimilhança LR− = 0.09 se parte depois do sinal de igual. A primeira prova é composta com citationBreaks e operatorBreaks em 'warn'. Ela não muda nenhuma quebra, marca cada uma com uma faixa âmbar-clara e as lista numa tira depois das referências. A segunda é composta com 'avoid', e das três resta uma. A edição espanhola compõe o mesmo estudo com vírgula decimal.
Esta receita responde a
- Como evito que um número de citação ou uma estatística como p < 0,05 se partam no fim de uma linha?
- Como coloco os números de citação em sobrescrito e transformo os DOIs em links, como fazem as revistas médicas?
A resposta curta
const bodyText = {
  fontFamily: SERIF, fontSize: pt(9.5), lineHeight: pt(LEAD), color: col('ink'),
  boldColor: col('ink'), italicColor: col('ink'), referenceColor: col('ink'),
  referenceBold: false, textAlign: 'justify', firstLineIndent: mm(3.5),
  indentAfterHeading: false, hyphenation: { enabled: true },
  optimalLineBreaking: true, // the rules price breaks in the Knuth–Plass breaker
  avoidWidows: true, avoidOrphans: true, avoidRunts: true,
  // A line that opens on a citation, "[8, 9]" (citationBreak), or ends or opens on a sign
  // set between spaces, "p <" / "0.05" (operatorBreak). 'warn' reports each one and changes
  // nothing; 'avoid' adds the penalty to the demerits of those breaks and reports the ones
  // it keeps. The first proof sets 'warn' (see proofs).
  citationBreaks: 'avoid', operatorBreaks: 'avoid',
  // 10000 by default, what a line spaced to the limit costs. A 66 mm column offers few other
  // breaks; at 30000 the breaker takes looser lines, never past maxWordSpacing.
  citationBreakPenalty: 30000, operatorBreakPenalty: 30000,
};
Ingredientes
- Funcionalidades
- Citações e sinais nas bordas da linhaQuebra de linha ótima (Knuth–Plass)Citações em um estilo de citaçãoBibliografia a partir das referênciasDestaquesHifenização e idioma do documentoUma ou duas colunasAberturas desenhadasAtributos de títuloEstilos de títuloCabeços e fóliosCabeços por tipo de páginaMargens espelhadasBoxesPaleta de cores semântica
- Também usa
- Sair da grade de propósitoEstilos de parágrafoElementos pré-textuais em romanosSobrescritos e subscritosCapítulos sem número
- Tipografia
- STIX Two Text, IBM Plex Sans, IBM Plex Sans Condensed (SIL OFL 1.1)
- Materiais
- Nenhum: todas as imagens são desenhadas em código
Preparo
#1 · Um preço para dois tipos de quebra
O código é a resposta curta logo acima. Há quebra de citação quando uma linha começa com uma chamada numerada, ou com a segunda metade de uma, como 5] depois de [4,. Há quebra de operador quando uma linha termina ou começa com um sinal entre espaços: =, <, ±, ×, o sinal de menos. 'warn' aponta as duas e deixa as linhas como estão. 'avoid' soma uma penalidade aos deméritos dessas quebras, e o algoritmo de Knuth–Plass procura outra forma de quebrar o parágrafo. Ele precisa de optimalLineBreaking: a quebra linha a linha não tem deméritos aos quais somar nada.
A penalidade padrão, 10000, é o que custa uma linha esticada até o limite do espaço entre palavras, então o algoritmo nunca abre uma linha além desse limite para manter uma chamada junto da sua palavra. Nesta coluna, 10000 deixava duas quebras em cada edição. Com 30000 o algoritmo aceita linhas mais abertas, sempre dentro de maxWordSpacing, e resta uma em cada edição. Um valor mais alto não mudava mais nada: a última quebra não tem alternativa dentro do limite.
#2 · Marcar as quebras no texto
// The word before the citation and the citation, or the sign and the number on its other
// side, wrapped in :mark[…]: a band under ordinary text, so the breaks stay where they were.
const wordEnd = (s, i) => i + s.slice(i).search(/[\s;)]|[,.](?!\d)|$/); // 0.09, not 0
function sides(source, w, a, b) { // a warning names line a, before the break, by its source
  if (w.kind === 'citationBreak') { // "colleagues [@simel1991]"
    const cite = source.lastIndexOf('[@', b.sourceStart + 2);
    return [source.lastIndexOf(' ', cite - 2) + 1, source.indexOf(']', cite) + 1];
  }
  if (w.edge === 'end') { // "LR− = 0.09": the sign ends line a, the number opens line b
    const from = source.lastIndexOf(` ${w.text} `, a.sourceEnd) + 1;
    return [from, wordEnd(source, from + w.text.length + 1)];
  }
  const sign = source.indexOf(` ${w.text} `, b.sourceStart - 1); // the sign opens line b
  return [source.lastIndexOf(' ', sign - 1) + 1, sign + 1 + w.text.length];
}
function markBreaks(source, doc, found) {
  const pairs = doc.blocks.flatMap((b) => b.lines.map((line, i) => [line, b.lines[i + 1]]));
  const spans = new Map();
  for (const w of found) {
    const [a, b] = pairs.find(([line]) => line.sourceStart === w.sourceStart) ?? [];
    const [from, to] = b ? sides(source, w, a, b) : [];
    if (from > a?.sourceStart && to > from && to <= b.sourceEnd) spans.set(from, to);
  }
  return [...spans].sort(([x], [y]) => y - x).reduce((md, [from, to]) => `${md.slice(0, from)}`
    + `:mark[${md.slice(from, to)}]{style="edge"}${md.slice(to)}`, source);
}
Cada aviso traz o tipo, a chamada ou o sinal, o texto das duas linhas, a posição da primeira no texto-fonte e a página. O script encontra essas duas linhas no documento composto e envolve a quebra em :mark[…]: a palavra antes da chamada e a chamada, ou o sinal e o número do outro lado. Uma marca pinta uma faixa sob o texto e deixa as quebras onde estavam. A faixa não alcança o número que o estilo de citação gera, por isso na página só a palavra anterior fica marcada.
#3 · Duas provas e uma tira de consultas
const KIND = { citationBreak: t({ en: 'citation', es: 'cita' }),
  operatorBreak: t({ en: 'sign', es: 'signo' }) };
const edge = (s, end) => (end ? s.trim().split(/\s+/).slice(-2) : s.trim().split(/\s+/)
  .slice(0, 2)).join('\u00a0').replace(/[.,;]$/, ''); // no-break spaces: no breaks of its own
const query = (doc, w) => `${t({ en: 'p.', es: 'pág.' })}\u00a0${doc.pages[w.pageIndex]
  .pageLabel}, ${KIND[w.kind]}: …${edge(w.lines[0], true)}\u00a0/ ${edge(w.lines[1])}…`;
const slip = (mode, doc, found) => ['', `:::callout{type="slip" title="${mode === 'warn'
  ? t({ en: 'First proof: queries', es: 'Primeras pruebas: consultas' })
  : t({ en: 'Second proof: queries', es: 'Segundas pruebas: consultas' })}"}`,
`citationBreaks / operatorBreaks: '${mode}' · ${found.length} ${found.length === 1
  ? t({ en: 'break', es: 'corte' }) : t({ en: 'breaks', es: 'cortes' })}.`,
...found.flatMap((w) => ['', query(doc, w)]), ':::', ''].join('\n');
const build = (md, mode) => buildDocumentWithFonts({ markdown: md }, { ...config,
  bodyText: { ...bodyText, citationBreaks: mode, operatorBreaks: mode } }, kitFonts(FONTS));
async function proof(mode) {
  const plain = await build(markdown, mode); // pass 1: where the breaks are
  const found = (plain.contentWarnings ?? []).filter((w) => /^(citation|operator)Break$/
    .test(w.kind));
  return build(markBreaks(markdown, plain, found) + slip(mode, plain, found), mode); // pass 2
}
const docs = { warn: await proof('warn'), avoid: await proof('avoid') };
Cada prova é composta duas vezes. A primeira composição encontra as quebras; a segunda compõe o artigo com as marcas e uma tira depois das referências, que cai assim na última página. É assim que um compositor devolve as provas com suas consultas. As linhas da tira unem as palavras com espaços não separáveis, para não criar quebras próprias. capture.doc publica as duas composições marcadas, [1, 3].
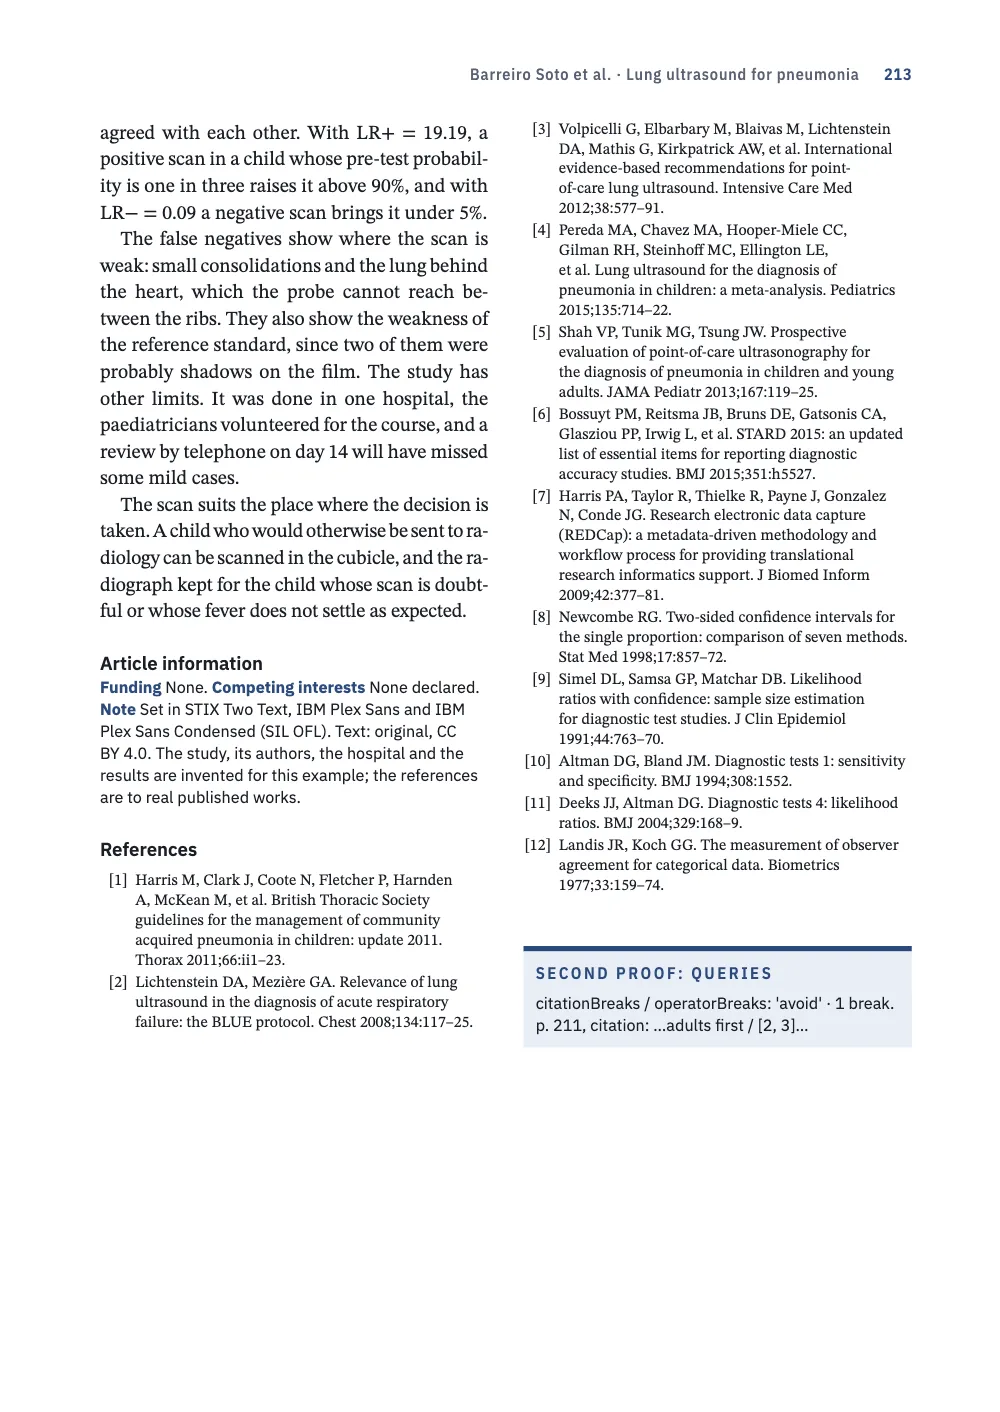
A quebra que resta em inglês é first sobre [2, 3], na página 211. Em espanhol a primeira prova encontra quatro, entre elas CP+ sobre = 19,19 e [4, sobre 5], em que a própria chamada se parte, e a segunda mantém uma, anteriores [4, sobre 5].
#4 · Chamadas numeradas entre colchetes
registerCitationEngine(createCiteprocEngine({ styles: STYLES, locales: LOCALES }));
const citations = { style: 'elsevier-vancouver', locale: t({ en: 'en-GB', es: 'es-ES' }),
  marker: 'brackets', collapseRanges: true, // [8, 9] and [4–6], set after a word space
  bibliography: { fontSize: em(0.8), lineHeight: pt(9.6), entrySpacing: pt(1),
    labelWidth: mm(6), labelAlign: 'right', doi: 'hide' } };
O processador de citações compõe cada [@key] como um número entre colchetes depois de um espaço e agrupa sequências como [4–6]. O espaço antes do colchete e o que vem depois de uma vírgula dentro dele são lugares onde uma linha pode quebrar, e por isso uma coluna estreita com muitas citações precisa da regra.
#5 · O cabeçalho da revista e o bloco do artigo
const text = (id, content, family, size, extra) => ({ kind: 'text', id, content, align: 'left',
  fontFamily: family, fontSize: pt(size), color: col('ink'), overflow: 'wrap', ...extra });
const at = (to, edge, x, y, width) => ({ anchor: { to, edge }, offset: { x: mm(x), y: mm(y) },
  ...(width && { size: { width: mm(width), height: 'auto' } }) });
const caps = { fontFamily: COND, fontWeight: 600, letterSpacing: pt(1.2),
  textTransform: 'uppercase' };
const JOURNAL = t({ en: 'Ribera Paediatric Journal', es: 'Revista Pediátrica de la Ribera' });
const white = { ...caps, color: col('paper') };
const titleBlock = { enabled: true, minHeight: mm(58), slot: { elements: [
  { kind: 'box', id: 'band', style: { backgroundColor: col('accent') }, placement: {
    anchor: { to: 'page', edge: 'top-left' }, size: { width: 'fill', height: mm(13) } } },
  text('journal', JOURNAL, COND, 9, { ...white, placement: at('page', 'top-left', INNER, 5) }),
  text('issue', '{attr.issue}', COND, 9, { ...white, align: 'right',
    placement: at('page', 'top-right', -OUTER, 5, 60) }),
  text('kind', '{attr.kind}', COND, 8.5, { ...caps, color: col('accent'),
    placement: at('container', 'top-left', 0, 0, MEASURE) }),
  text('title', '{titleText}', SANS, 16, { fontWeight: 600, lineHeight: 1.18,
    placement: at('#kind', 'below', 0, 2.5, MEASURE - 6) }),
  text('authors', '{attr.authors}', SERIF, 10, { inlineMarks: true, // ^1^ → ¹
    placement: at('#title', 'below', 0, 3.5, MEASURE) }),
  text('affiliations', '{attr.affiliations}', SANS, 7.2, { inlineMarks: true, lineHeight: 1.35,
    color: col('muted'), placement: at('#authors', 'below', 0, 1.6, MEASURE) }),
  text('note', '{attr.note}', SANS, 7.2, { color: col('muted'),
    placement: at('#affiliations', 'below', 0, 2.4, MEASURE) }),
] } };
O estilo do título desenha a faixa da revista, o tipo de artigo, o título, os autores com seus números de afiliação e uma nota, tudo a partir de atributos do H1. As duas edições compartilham o estilo, e o texto fica no Markdown.
A receita completa
// ═══ Postext Cookbook · Nº 186 · Citations and statistics off the line edges ═══════════
// https://postext.dev/en/cookbook/clinical-paper-line-edges
// Code: MIT · Text: original (CC BY 4.0) · Pictures: none
// Fonts: STIX Two Text, IBM Plex Sans and Sans Condensed (SIL OFL 1.1) · Needs postext ≥ 1.79.0
import {
  buildDocumentWithFonts, renderPageToCanvas, registerCitationEngine,
} from 'https://esm.sh/postext';
import { createCiteprocEngine, STYLES, LOCALES } from 'https://esm.sh/postext-citeproc';

const LANG = 'en'; // @lang: the language of the sample document ('en' | 'es')
const RECIPE = 'clinical-paper-line-edges';

// ─── 1 · Design ─────────────────────────────────────────────────────────────
// #region palette: an indigo journal, a pale amber band for the proof marks
const palette = { ink: '#1b1e26', accent: '#2c4a7c', tint: '#e9eef6', mark: '#f7dfa9',
  muted: '#596173', paper: '#ffffff' };
const col = (id) => ({ hex: palette[id], model: 'hex', paletteId: id });
const colorPalette = Object.entries({ ...palette, 'main-color': palette.accent })
  .map(([id, hex]) => ({ id, name: id, value: { hex, model: 'hex' } }));
// #endregion
const [SERIF, SANS, COND] = ['STIX Two Text', 'IBM Plex Sans', 'IBM Plex Sans Condensed'];
const [TRIM_W, TRIM_H, TOP, BOTTOM, INNER, OUTER, GUTTER] = [170, 240, 20, 22, 17, 15, 6];
const MEASURE = TRIM_W - INNER - OUTER; // 138 mm: two columns of 66 mm, about 45 characters
const LEAD = 12.8; // pt, for 9.5 pt type

// #region answer: no line opens on a citation, no line ends or opens on a lone sign
const bodyText = {
  fontFamily: SERIF, fontSize: pt(9.5), lineHeight: pt(LEAD), color: col('ink'),
  boldColor: col('ink'), italicColor: col('ink'), referenceColor: col('ink'),
  referenceBold: false, textAlign: 'justify', firstLineIndent: mm(3.5),
  indentAfterHeading: false, hyphenation: { enabled: true },
  optimalLineBreaking: true, // the rules price breaks in the Knuth–Plass breaker
  avoidWidows: true, avoidOrphans: true, avoidRunts: true,
  // A line that opens on a citation, "[8, 9]" (citationBreak), or ends or opens on a sign
  // set between spaces, "p <" / "0.05" (operatorBreak). 'warn' reports each one and changes
  // nothing; 'avoid' adds the penalty to the demerits of those breaks and reports the ones
  // it keeps. The first proof sets 'warn' (see proofs).
  citationBreaks: 'avoid', operatorBreaks: 'avoid',
  // 10000 by default, what a line spaced to the limit costs. A 66 mm column offers few other
  // breaks; at 30000 the breaker takes looser lines, never past maxWordSpacing.
  citationBreakPenalty: 30000, operatorBreakPenalty: 30000,
};
// #endregion

// #region citations: numbered references in brackets, the list in the Vancouver order
registerCitationEngine(createCiteprocEngine({ styles: STYLES, locales: LOCALES }));
const citations = { style: 'elsevier-vancouver', locale: t({ en: 'en-GB', es: 'es-ES' }),
  marker: 'brackets', collapseRanges: true, // [8, 9] and [4–6], set after a word space
O script.js montado funciona como está: cole-o como script de módulo em qualquer página ou abra a receita no CodePen. Pasta da receita no GitHub ↗ (abre em uma nova aba)
Variações
#Apontar as quebras sem mudar nada
Uma revista que confere as provas à mão pode deixar a regra em 'warn': o Sandbox lista cada quebra entre seus avisos, e as linhas ficam como o algoritmo as quebrou.
-  citationBreaks: 'avoid', operatorBreaks: 'avoid',
+ citationBreaks: 'warn', operatorBreaks: 'warn',#Manter a penalidade padrão
Com 10000 o espaçamento fica um pouco mais apertado e restam duas quebras por edição em vez de uma.
- citationBreakPenalty: 30000, operatorBreakPenalty: 30000,Erros comuns
Aviso de diagramação · citationBreak
Citação no início da linha
Por quê. Uma linha de um parágrafo começa com uma citação numerada posta depois de uma palavra, ou com um pedaço dela: «autores» no fim de uma linha e «[12]» no início da seguinte, ou «[14,» sobre «16]». Um número entre colchetes ou parênteses depois de um número não é citação («2016 (3)»), nem uma palavra entre colchetes. O texto da direita para a esquerda e o chinês, japonês ou coreano ficam como estão. Com bodyText.citationBreaks em 'warn' todas essas quebras são assinaladas; em 'avoid', as que a quebra de linha manteve porque nenhuma composição dentro do espaçamento entre palavras as evitava por menos que bodyText.citationBreakPenalty. O motor regista cada uma em doc.contentWarnings com a citação, as duas linhas e a página.
Correção. Ponha bodyText.citationBreaks em 'avoid': a quebra de linha põe preço a uma quebra antes de uma citação ou dentro dela e compõe o parágrafo de outro modo onde o espaçamento entre palavras permite; o espaço continua a esticar com os outros. Uma quebra que fica custa mais a evitar que bodyText.citationBreakPenalty, muitas vezes porque a citação é larga para a medida: aumente a penalização para a trocar por linhas mais soltas, ou escreva um espaço não separável (U+00A0) entre a palavra e a citação para unir esse par seja qual for a regra. Num port de um livro existente mantenha 'warn': o port reproduz as quebras do original. Docs →
Aviso de diagramação · operatorBreak
Sinal na borda da linha
Por quê. Uma linha de um parágrafo termina ou começa com um sinal solto entre espaços, um de = < > ≤ ≥ ± × ≈ ≠ ÷ − + · →: «LR+ =» no fim de uma linha com «18,29» na seguinte, ou «± 0,03» no início de uma linha. Um hífen entre palavras não é sinal. O texto da direita para a esquerda e o chinês, japonês ou coreano ficam como estão. Com bodyText.operatorBreaks em 'warn' todas essas quebras são assinaladas, uma por quebra (uma linha que começa e termina com um sinal dá duas); em 'avoid', as que a quebra de linha manteve porque nenhuma composição dentro do espaçamento entre palavras as evitava por menos que bodyText.operatorBreakPenalty. O motor regista cada uma em doc.contentWarnings com o sinal, a borda (fim ou início), as duas linhas e a página.
Correção. Ponha bodyText.operatorBreaks em 'avoid': a quebra de linha põe preço a uma quebra nos espaços dos dois lados do sinal e compõe o parágrafo de outro modo onde o espaçamento entre palavras permite. Uma quebra que fica custa mais a evitar que bodyText.operatorBreakPenalty, muitas vezes numa coluna estreita onde o sinal e os seus dois termos são largos: aumente a penalização para a trocar por linhas mais soltas, ou escreva espaços não separáveis (U+00A0, ou U+202F para um fino) à volta do sinal para o unir seja qual for a regra. Num port de um livro existente mantenha 'warn': o port reproduz as quebras do original. Docs →
- As quebras são procuradas nas linhas já quebradas. Uma mudança de formato, corpo ou texto as desloca: leia os avisos de cada composição e não copie posições de uma anterior.
- Para manter uma chamada específica junto da sua palavra em qualquer coluna, digite um espaço não separável antes dela no Markdown. A regra cuida do resto do artigo.
Créditos
- Receita
- Ignacio Ferro
- Texto
- Texto original, CC BY 4.0
- Fontes
- STIX Two Text (SIL OFL 1.1) · IBM Plex Sans (SIL OFL 1.1) · IBM Plex Sans Condensed (SIL OFL 1.1)
- Código
- MIT, como o Postext
Editar este texto ↗ (abre em uma nova aba)Pasta da receita no GitHub ↗ (abre em uma nova aba)