Em poucas palavras
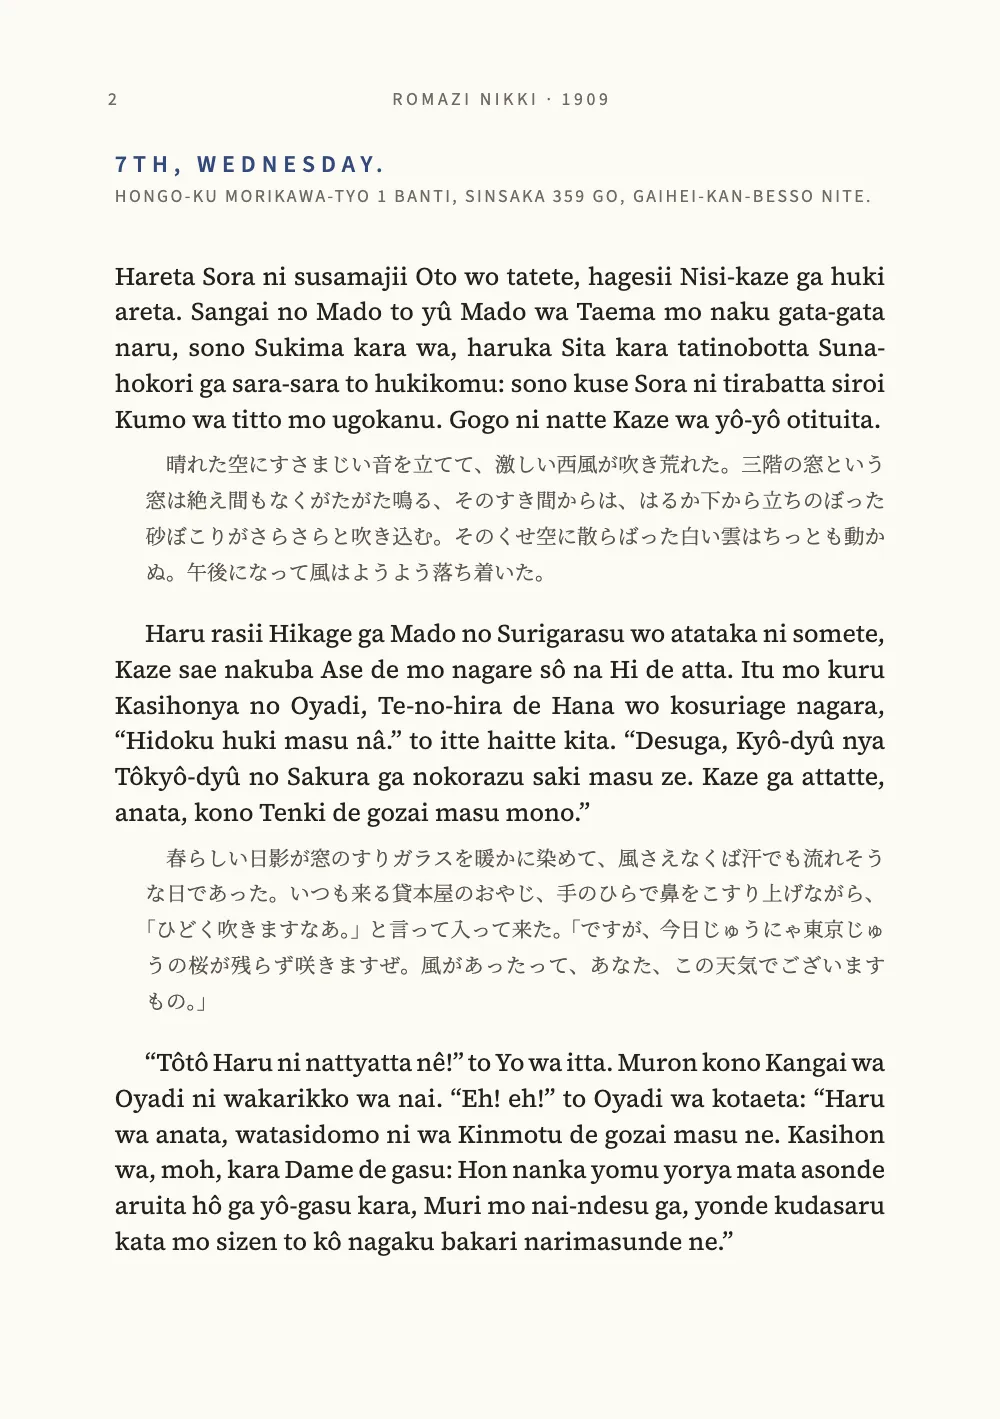
A primeira entrada de um diário de 1909 que o poeta Takuboku escreveu em japonês com letras latinas, com a leitura em escrita japonesa embaixo de cada parágrafo.
O que você vai compor
Quatro páginas do Rōmaji nikki, o diário que Ishikawa Takuboku manteve em Tóquio na primavera de 1909 em letras latinas, para que a mulher não conseguisse lê-lo: as linhas do alto do caderno e a primeira entrada, a de 7 de abril, até Kanasii koto da! O diário é composto como edição de estudo numa página A5: o rōmaji em Source Serif 4, justificado e sem nunca dividir uma palavra, e, embaixo de cada parágrafo, a leitura em kana e kanji em Noto Serif JP, menor, mais clara e recuada. Takuboku escreve no sistema Nippon-shiki, si, tu, hu, com circunflexo nas vogais longas, Tôkyô; as linhas do editor usam Hepburn com mácrons, Rōmaji, e as duas grafias chegam ao PDF.
Esta receita responde a
- Como componho japonês em rōmaji: qual tag de idioma, que hifenização e mácrons no PDF?
- Quais fontes compõem japonês, com os kanji nas formas japonesas, na tela e no PDF?
A resposta curta
// ja-Latn is Japanese written in Latin script (BCP 47). Its language is ja, so the kana
// under each paragraph get the Japanese rules (kinsoku, 、。 spacing, the space after !)
// and the built-in strings are Japanese; and Japanese has no hyphenation patterns, so the
// rōmaji is never divided at a line end. English patterns would divide tatinobotta or
// Surigarasu by English syllables, not by the morae a Japanese reader hears.
const language = { locale: 'ja-Latn' }; // spread into the config
const bodyText = {
  fontFamily: SERIF, fontSize: pt(BODY), lineHeight: pt(LEAD), color: col('ink'),
  boldColor: col('ink'), italicColor: col('ink'), referenceColor: col('ink'),
  textAlign: 'justify', firstLineIndent: em(1.2), indentAfterHeading: false,
  optimalLineBreaking: true, maxWordSpacing: 1.8, // no hyphens: the spaces take the slack
};
// The reading in kana, under its paragraph: smaller, a shade lighter, indented.
const kana = { id: 'kana', fontFamily: MINCHO, fontSize: pt(8.6), lineHeight: pt(LEAD),
  color: col('kana'), textAlign: 'justify', indent: em(1.5), firstLineIndent: em(1),
  marginTop: pt(LEAD / 4), marginBottom: pt(LEAD * 0.75) };
Ingredientes
- Funcionalidades
- Kana, kanji e rōmajiHifenização e idioma do documentoFontes chinesas, japonesas e coreanasEspaçamento da pontuação japonesa (yakumono)Quebra de linha em japonês (kinsoku)Tipografia do textoAberturas desenhadasEstilos de títuloAtributos de títuloEstilos de parágrafoCabeços e fóliosCabeços por tipo de páginaMargens espelhadasCor do papelPaleta de cores semânticaExportação para PDFFontes incorporadas ao PDF
- Tipografia
- Source Serif 4, Source Sans 3, Noto Serif JP (SIL OFL 1.1)
- Materiais
- Nenhum: todas as imagens são desenhadas em código
Preparo
#1 · Marque o texto como ja-Latn
O código é a resposta curta lá em cima. ja-Latn é a etiqueta BCP 47 do japonês escrito em alfabeto latino. O idioma dela é ja, por isso a leitura embaixo de cada parágrafo segue as regras japonesas: kinsoku, o espaçamento de 、。 e o espaço eme que o motor acrescenta depois de ! dentro de uma frase, como em 「ええ! ええ!」. O japonês não tem padrões de hifenização, por isso o rōmaji nunca se divide; com en, os padrões ingleses quebrariam palavras como tatinobotta ou Surigarasu pelas sílabas do inglês, e não pelas moras que um leitor japonês ouve. Sem hífens, os espaços absorvem a folga, e por isso a medida fica em torno de 70 caracteres e maxWordSpacing vale 1,8 (hifenização).
#2 · Leve os mácrons ao PDF
// Fontsource keeps ō ū ā in a latin-ext file. cjkPdfProvider serves Noto Serif JP from its
// slices, and adds that file after the latin one for a Latin face whose text needs it.
offerPdf(() => renderToPdf(doc, { fontProvider: cjkPdfProvider }), `${RECIPE}.pdf`);
O Fontsource guarda ō ū ā num arquivo latin-ext à parte. A tela o carrega (loadFonts encontra o ō da amostra), e o cjkPdfProvider do kit faz o mesmo para o PDF. Ele serve a Noto Serif JP a partir dos recortes japoneses e, quando uma fonte latina compõe uma letra que só existe em latin-ext, responde com dois arquivos, latin e depois latin-ext; o postext-pdf tira cada glifo do primeiro arquivo que o tiver. O fontsourceProvider simples do kit entrega ao PDF apenas o arquivo latin: com ele, o PDF ficaria sem glifo para o ō.
#3 · Abra com as linhas do próprio diário
const onField = { color: col('paper'), align: 'center', overflow: 'wrap' };
const title = {
  id: 'title', numbered: false, toc: false, span: 'page', runningChapter: false,
  breakBefore: { enabled: true, parity: 'any' }, // its page is an opener: no running heads
  advancedDesign: { enabled: true, minHeight: mm(166), slot: { elements: [
    { kind: 'box', id: 'field', style: { backgroundColor: col('indigo') },
      placement: { anchor: { to: 'bleed', edge: 'top-left' }, size: { width: 'fill',
        height: 'fill' } } },
    { kind: 'text', id: 'lines', content: '{attr.lines}', ...onField, fontFamily: SERIF,
      fontWeight: 600, fontSize: pt(20), lineHeight: 1.9, letterSpacing: pt(5),
      placement: { anchor: { to: 'container', edge: 'top' }, offset: { y: mm(18) } } },
    { kind: 'rule', id: 'rule', thickness: pt(0.5), color: col('paper'),
      placement: { anchor: { to: 'container', edge: 'top' }, offset: { y: mm(122) },
        size: { width: mm(24) } } },
    { kind: 'text', id: 'note', content: '{attr.note}', inlineMarks: true, ...onField,
      fontFamily: SANS, fontSize: pt(8.5), lineHeight: 1.5, placement: { anchor: { to:
        'container', edge: 'top' }, offset: { y: mm(130) }, size: { width: mm(84) } } },
  ] } },
};
// The entry: its day as a heading, the address under it from an attribute.
const entry = {
  level: 2, fontFamily: SANS, fontWeight: 600, fontSize: pt(10), letterSpacing: pt(2.5),
  color: col('indigo'), marginTop: pt(LEAD), marginBottom: pt(LEAD), advancedDesign: {
    enabled: true, minHeight: pt(2 * LEAD), slot: { elements: [
      { kind: 'text', id: 'day', content: '{titleText}', fontFamily: SANS, fontWeight: 600,
        fontSize: pt(10), letterSpacing: pt(2.5), color: col('indigo'),
        placement: { anchor: { to: 'container', edge: 'top-left' } } },
      { kind: 'text', id: 'place', content: '{attr.place}', fontFamily: SANS, fontSize: pt(7.5),
        letterSpacing: pt(1), color: col('muted'), overflow: 'wrap', align: 'left',
        placement: { anchor: { to: 'container', edge: 'top-left' }, offset: { y: pt(LEAD) },
          size: { width: 'fill' } } },
    ] } },
};
O caderno começa com NIKKI. I. MEIDI 42 NEN. 1909. APRIL. TOKYO., um item por linha. O título as recebe de um atributo, cada \n uma linha nova, e as compõe em maiúsculas espaçadas sobre um campo índigo, o pano da capa de um caderno. A página dele é uma abertura, por isso os cabeços não aparecem nela.
#4 · Cabeços pela paridade
const head = (id, content, parity, edge) => ({ kind: 'text', id, content, parity,
  pages: 'body', fontFamily: SANS, fontSize: pt(7.5), letterSpacing: pt(1.5), color: col('muted'),
  placement: { anchor: { to: 'page', edge }, offset: { y: mm(13), // 'top' centres on the page
    x: mm(edge.endsWith('left') ? 16 : edge.endsWith('right') ? -16 : 0) } } });
const header = { elements: [
  head('folio-even', '{pageNumber}', 'even', 'top-left'),
  head('book', 'ROMAZI NIKKI · 1909', 'even', 'top'),
  head('place', 'TOKYO · APRIL', 'odd', 'top'),
  head('folio-odd', '{pageNumber}', 'odd', 'top-right'),
] };
A página par leva o nome do diário, e a ímpar, o lugar e o mês, com os fólios nos cantos externos, em Source Sans 3 de 7,5 pt.
A receita completa
// ═══ Postext Cookbook · Nº 130 · Japanese in Latin letters: Takuboku's Rōmaji Diary ════
// https://postext.dev/en/cookbook/romaji-nikki
// Code: MIT · Text: Ishikawa Takuboku, 1909 (public domain); transcription (CC BY 4.0)
// Fonts: Source Serif 4, Source Sans 3, Noto Serif JP (SIL OFL 1.1) · Needs postext ≥ 1.25.0
// A diary written in Japanese with Latin letters, and its reading in kana under each paragraph.
import { buildDocument, withLoadedFonts, renderPageToCanvas } from 'https://esm.sh/postext';
import { renderToPdf, decompressWoff2 } from 'https://esm.sh/postext-pdf';

const LANG = 'en'; // @lang: the language of the note; the diary is Japanese in both editions
const RECIPE = 'romaji-nikki';

// ─── 1 · Design ─────────────────────────────────────────────────────────────
// #region palette: diary ink, a faded indigo, the cream of a notebook
const palette = {
  ink: '#22201d', // the rōmaji
  indigo: '#34497a', // the date and the title (8.4:1 on the paper)
  kana: '#5a554e', // the transcription, a step lighter than the text (7:1)
  rule: '#c9c1b2',
  muted: '#6f6a62', // running heads, folios, the note
  paper: '#fcfaf4',
};
const col = (id) => ({ hex: palette[id], model: 'hex', paletteId: id });
const colorPalette = [
  ...Object.entries(palette).map(([id, hex]) => ({ id, name: id, value: { hex, model: 'hex' } })),
  { id: 'main-color', name: 'indigo (defaults)', value: { hex: palette.indigo, model: 'hex' } },
];
// #endregion

const SERIF = 'Source Serif 4'; // the rōmaji: ô û â ê in latin, ō ū in latin-ext
const SANS = 'Source Sans 3'; // labels, running heads, folios, the note
const MINCHO = 'Noto Serif JP'; // the kana: Noto Serif JP's Latin is Source Serif's
const [BODY, LEAD] = [10.5, 15]; // pt

// #region answer: a Japanese text in Latin letters is tagged ja-Latn
// ja-Latn is Japanese written in Latin script (BCP 47). Its language is ja, so the kana
// under each paragraph get the Japanese rules (kinsoku, 、。 spacing, the space after !)
// and the built-in strings are Japanese; and Japanese has no hyphenation patterns, so the
// rōmaji is never divided at a line end. English patterns would divide tatinobotta or
// Surigarasu by English syllables, not by the morae a Japanese reader hears.
const language = { locale: 'ja-Latn' }; // spread into the config
const bodyText = {
  fontFamily: SERIF, fontSize: pt(BODY), lineHeight: pt(LEAD), color: col('ink'),
  boldColor: col('ink'), italicColor: col('ink'), referenceColor: col('ink'),
  textAlign: 'justify', firstLineIndent: em(1.2), indentAfterHeading: false,
  optimalLineBreaking: true, maxWordSpacing: 1.8, // no hyphens: the spaces take the slack
};
// The reading in kana, under its paragraph: smaller, a shade lighter, indented.
const kana = { id: 'kana', fontFamily: MINCHO, fontSize: pt(8.6), lineHeight: pt(LEAD),
O script.js montado funciona como está: cole-o como script de módulo em qualquer página ou abra a receita no CodePen. Pasta da receita no GitHub ↗ (abre em uma nova aba)
Variações
#Escreva o rōmaji em Hepburn
Uma edição moderna pode regrafar o diário em Hepburn com mácrons, Tōkyō em vez de Tôkyô. O PDF já traz o ō, de modo que só o texto muda; mantenha uma nota dizendo que a grafia é do editor.
#Hifenize entre moras
Se uma coluna estreita precisar de hífens, coloque hífens discricionários (U+00AD) entre as moras do rōmaji, Su\u00adna-ho\u00adko\u00adri no código ou um U+00AD digitado no texto: um documento marcado ja-Latn nunca hifeniza sozinho, mas quebra num hífen discricionário quando uma palavra não cabe.
Erros comuns
Erro comum
Marque um texto japonês como 'ja', nunca com zh-Hans nem LANG
As edições de uma receita são en e es, mas uma amostra japonesa é japonesa nas duas: `locale: LANG` a marcaria como inglês ou espanhol, e uma marcação chinesa a comporia pelas regras chinesas (pontuação Kaiming, kana pequeno livre para começar linha, 图 no lugar de 図, formas chinesas dos glifos no PDF). Desde o postext 1.30 a marcação é também o idioma em que o texto é composto (em que é medido, pintado e incorporado), então qualquer marcação que não seja 'ja' dá outras formas de glifo que não as japonesas (as chinesas, sob uma marcação chinesa) e outras quebras de linha. Escreva 'ja': isso escolhe a região do Japão (quebra de linha e pontuação da JLReq, pontos de ênfase em gergelim, espaçamento dos furigana, rótulos 図 e 表) e desativa a hifenização. O lint reprova um texto com kana sob uma marcação zh ou ko. Quebra de linha em japonês (kinsoku) →
Erro comum
Componha o japonês com uma fonte japonesa
A Noto Serif SC e a TC têm kana, mas desenham os kanji com formas chinesas (直, 骨 e 角 mudam) e o kana com desenho chinês. Componha o texto em Noto Serif JP ou Shippori Mincho B1 e os títulos em Noto Sans JP, carregadas com loadCjkFonts. Os arquivos japoneses do Fontsource não têm hentaigana nem outros kana históricos (U+1B000–1B16F): loadCjkFonts falha com eles e o PDF imprime caixas, então escreva o kana moderno ou inclua nos recursos da receita uma fonte que os tenha. A Shippori Mincho também não tem as vogais com mácron ō e ū: componha o rōmaji com uma fonte latina. Kana, kanji e rōmaji →
Erro comum
Fontes chinesas são carregadas em fatias, pelo bloco cjk
O Fontsource serve uma família chinesa, japonesa ou coreana em cerca de cem arquivos por peso, cada um com um intervalo de caracteres. loadFonts baixa só o arquivo latin, então na tela os caracteres chineses vêm de uma fonte do sistema e são medidos errado, e o fontsourceProvider entrega ao PDF esse arquivo latin, que os imprime como caixas vazias. Inclua o bloco cjk do kit, chame loadCjkFonts(FONTS, markdown) depois de loadFonts (uma vez por voz, com o texto que ela compõe, quando o livro usa várias fontes CJK) e passe a renderToPdf fontProvider: cjkPdfProvider: os dois pegam os arquivos que contêm os caracteres do texto. Fontes chinesas, japonesas e coreanas →
- A Shippori Mincho não tem ō nem ū; a Noto Serif JP e a Source Serif 4 os têm nos arquivos
latin-ext. Confira a fonte antes de escolhê-la para um texto em Hepburn. - O chinês em letras latinas é o pinyin, composto como rubi sobre os caracteres em Uma cartilha com pinyin sobre cada caractere; o rōmaji de Takuboku é o próprio texto, por isso é composto como texto latino, com o espaçamento, e não como anotação.
Créditos
- Receita
- Ignacio Ferro
- Texto
- Ishikawa Takuboku, ROMAZI NIKKI (the Rōmaji Diary), the entry of 7 April 1909 to “Kanasii koto da!”, in Latin letters as he wrote it, after the Iwanami Bunko edition (ed. Kuwabara Takeo, 1977) as transcribed on the blog 啄木の息 · Ishikawa Takuboku (1886–1912) · domínio público
- The transcription into kana and kanji under each paragraph and the note on the text, written for this recipe · Postext Cookbook · CC BY 4.0
- Fontes
- Source Serif 4 (SIL OFL 1.1) · Source Sans 3 (SIL OFL 1.1) · Noto Serif JP (SIL OFL 1.1)
- Código
- MIT, como o Postext
Editar este texto ↗ (abre em uma nova aba)Pasta da receita no GitHub ↗ (abre em uma nova aba)