Em poucas palavras
Um capítulo de um livro japonês de programação, cheio de palavras em inglês, código e números. O Postext compõe a pontuação e as quebras de linha pelas regras japonesas e põe um espaço fino onde o japonês encontra o latim.
O que você vai compor
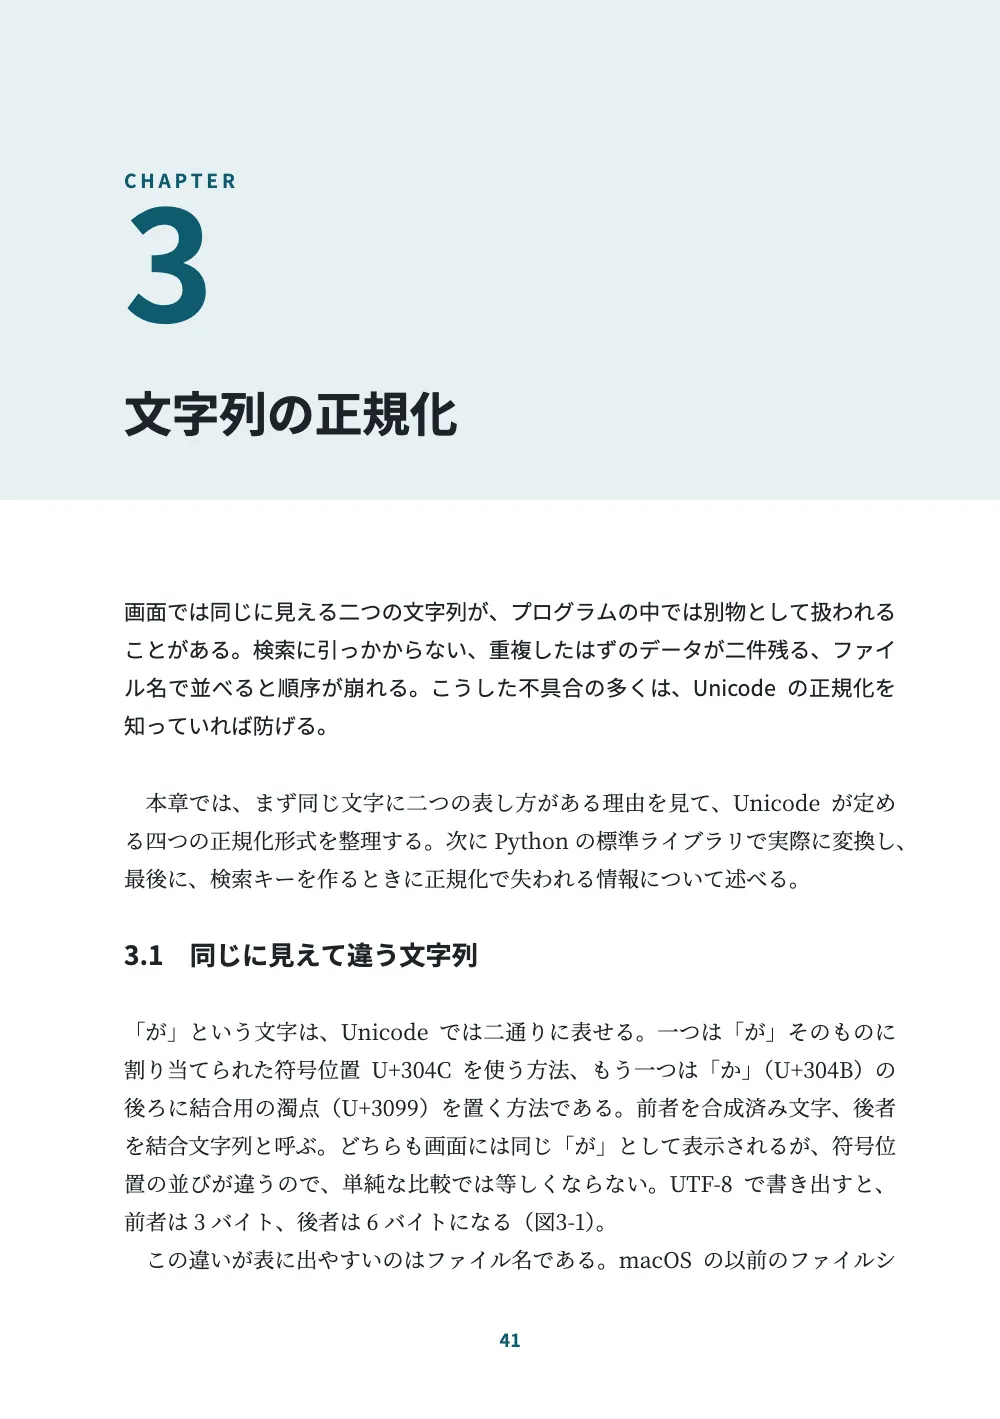
Cinco páginas do capítulo 3 de um livro japonês de programação inventado, 実践 日本語テキスト処理 (Processamento prático de texto japonês), sobre normalização Unicode. Ele é composto como os livros japoneses de informática: A5, uma coluna de 36 caracteres por 29 linhas de Noto Serif JP em 9 pt, títulos em Noto Sans JP e código em BIZ UDGothic. O texto é o caso difícil da composição japonesa, porque quase toda frase traz uma palavra latina, um ponto de código, um número ou um nome de função: as quebras de linha seguem o 禁則処理 (kinsoku shori) mais estrito do JLReq, a pontuação mantém seu espaçamento de largura inteira e um quarto de eme separa o japonês do latim sem que ninguém digite um espaço. Uma figura, uma tabela, uma listagem de código e notas de rodapé vêm com rótulos japoneses: 図3-1, 表3-1 e números de nota sobrescritos, contados por página. Listagens de código e teclas é o mesmo tipo de página em inglês.
Esta receita responde a
- Como espaço a pontuação japonesa: 、。「」 apertados onde se encontram, um espaço depois de ?! e o colchete que abre um parágrafo?
- Por que kana pequenos, ー e sinais de fechamento não podem começar uma linha em japonês, e como escolho o rigor da regra?
- Por que meu texto japonês sai com regras chinesas: rótulos 图, kana pequenos no início da linha, kanji em formas chinesas?
A resposta curta
// locale 'ja' turns on JLReq composition: kinsoku at its strictest, full-width marks squeezed
// where two meet (」、 takes one em, not two), a closing mark keeps its half em at a line
// end, 、。 may hang past it, and a paragraph opening with 「 sets the bracket in the indent.
// The values below are the ones 'auto' picks for 'ja'; they are spelled out to be seen.
const cjk = {
  lineBreak: 'ja-very-strict', // no line starts with ー, small kana, 々, 」、。?・ or :
  punctuationWidth: 'fullwidth', // 、。「」 keep their em inside the line (JLReq §3.1.2)
  hangingPunctuation: 'allow', // 、。 hang only when the line would otherwise break before them
  paragraphStartBracket: 'half', // 「 at a paragraph start sits in the indent's second half
  latinSpacing: em(0.25), // 四分アキ between kana or kanji and Latin letters or digits
  grid: { enabled: true, charsPerLine: CHARS, linesPerPage: LINES }, // whole ems, whole lines
};
// The Latin is the Japanese face's own proportional Latin, at the text's size: never
// full-width A or a second face for the words in parentheses.
const bodyText = {
  fontFamily: MINCHO, fontSize: pt(BODY), lineHeight: pt(PITCH), color: col('ink'),
  boldColor: col('ink'), italicColor: col('ink'), referenceColor: col('ink'),
  textAlign: 'justify', firstLineIndent: em(1), indentAfterHeading: true, // 1 字下げ
  referenceBold: false, // 図3-1 and 表3-1 in the text weight: the face loads no bold
  hyphenation: { enabled: false }, avoidRunts: true, // no one-character last line
  // The grid cuts a list where the page ends: the four forms stay in one piece.
  shortListSplit: 'avoid', shortListMaxItems: 4,
};
Ingredientes
- Funcionalidades
- Espaçamento da pontuação japonesa (yakumono)Quebra de linha em japonês (kinsoku)Espaço entre chinês e latimNotas nos livros japonesesNotas de rodapéEndereços dos links no papelLegendas numeradasFigura e Tabela no seu idiomaTítulos numeradosTítulos sobre linhas do texto (gyōdori)Grade de caracteresFontes chinesas, japonesas e coreanasListagens de códigoBoxesEstilo de tabelaEstilo de legendaFiguras e tabelas como recursosCabeços e fóliosAberturas desenhadasExportação para PDF
- Também usa
- Citações em um estilo de citaçãoQuebra de linha em chinêsLargura da pontuação chinesaEquilíbrio de colunasReferências cruzadasFiguras exatamente aquiCabeços por tipo de páginaEstilos de parágrafoFontes incorporadas ao PDFTipos de recurso personalizadosTabelas a partir de dados
- Tipografia
- Noto Serif JP, Noto Sans JP, BIZ UDGothic (SIL OFL 1.1)
- Materiais
- Figure 3-1, the bytes of が, drawn in code in the page’s palette (Postext Cookbook, CC BY 4.0)
Preparo
#1 · As regras japonesas vêm com a etiqueta de idioma
O código é a resposta curta logo acima. locale: 'ja' liga as regras do JLReq, os Requirements for Japanese Text Layout do W3C, e os valores escritos em cjk são os que 'auto' escolhe para o japonês (Tipografia do Leste Asiático). Com ja-very-strict, nenhuma linha começa com ー, um kana pequeno, 々 ou um sinal de fechamento, e nenhuma termina com um parêntese ou colchete de abertura. A pontuação (約物, yakumono) mantém seu eme inteiro dentro da linha, e dois sinais que se encontram, como 」、, dividem um eme. Na página 41, a linha que termina em 実際に変換し、 põe o 、 além da borda direita da medida: é o ぶら下げ (burasage), e o motor só o usa quando, sem ele, teria de empurrar o sinal para a linha seguinte. latinSpacing põe um quarto de eme (四分アキ, shibun aki) entre Unicode e では, e entre U+304C e を, embora o Markdown não tenha espaço ali. Ele só entra junto de uma letra ou de um algarismo: normalize() e is_normalized() terminam em parêntese, de modo que o Markdown leva um espaço entre eles e 関数.
A diferença em relação ao chinês está nos sinais. Um livro chinês do continente compõe 、 e , em meia largura por padrão e 。 em largura inteira (Kaiming); um japonês mantém todos os sinais em largura inteira e só os aperta onde dois se encontram. As quebras do chinês não têm kana pequeno nem ー para afastar do início da linha, por isso ja-very-strict é um nível à parte.
#2 · Código numa fonte monoespaçada que tem kana
// A ``` fence is set line by line as written, in codeStyle's face: the monospaced face,
// which has kana and kanji too, so a full-width character takes two half-width cells.
// The rest of the fence line (normalize.py) is the listing's title. Inline `code` is set
// in the same face, in the accent.
const codeStyle = {
  fontFamily: CODE, fontSize: pt(8), lineHeight: pt(12), color: col('ink'),
  background: col('tint'), snapToGrid: false, highlight: 'none', // one ink, as in print
  padding: { top: mm(2.5), right: mm(4), bottom: mm(3), left: mm(4) },
  marginTop: mm(2), marginBottom: mm(2),
  titleStyle: { fontFamily: CODE, fontSize: pt(7), fontWeight: 400, color: col('teal') },
  inline: { fontSize: pt(8.5), color: col('teal') },
};
A listagem é um bloco de código: o Postext compõe suas linhas como foram escritas, na fonte que codeStyle indica, num boxe com fundo de cor sob o título normalize.py, tirado da linha de abertura (listagens de código). highlight: 'none' deixa a listagem numa só tinta, como o resto da página, e codeStyle.inline compõe cada `name` na mesma fonte, em verde-azulado. A fonte faz diferença: a string do exemplo, ガイド ABC ①, precisa de katakana de meia largura, letras de largura inteira e algarismos em círculo, que uma fonte de código ocidental não tem. A BIZ UDGothic compõe o latim de meia largura e o kana de largura inteira com passo fixo, e uma listagem conta cada caractere de largura inteira como duas células; assim as colunas se mantêm.
#3 · 図3-1 e 表3-1
const FORMS = `入力\tNFC\tNFD\tNFKC
が(U+304C)\tU+304C\tU+304B U+3099\tU+304C
ガ(U+FF76 U+FF9E)\tそのまま\tそのまま\tガ(U+30AC)
ABC(全角)\tそのまま\tそのまま\tABC
①\tそのまま\tそのまま\t1
㍻\tそのまま\tそのまま\t平成`;
const resources = [
  { id: 'tbl:forms', typeId: 'table', kind: 'table', createdAt: 0, updatedAt: 0,
    placement: { position: 'here' }, // at its ::resource line, under the paragraph citing it
    caption: '日本語の文字と四つの正規化形式(NFKDは、NFKCで合成された文字を分解した形になる)',
    table: { model: { ...parseTSV(FORMS), headerRowCount: 1, columnWidths: [34, 18, 26, 22] } } },
  { id: 'fig:bytes', typeId: 'figure', kind: 'svg', createdAt: 0, updatedAt: 0,
    caption: '「が」の二つの表し方。上段が符号位置、下段がUTF-8のバイト列',
    altText: 'が as one code point U+304C, three UTF-8 bytes E3 81 8C; and as U+304B and the '
      + 'combining voiced mark U+3099, six bytes E3 81 8B E3 82 99.',
    svg: { fileId: 'bytes.svg', width: 1175, height: 400 } },
];
defaultResourceTypes('ja') dá aos tipos os nomes 図 e 表 e os numera por capítulo com hífen, e continuation.headings faz deste o capítulo 3, por isso a primeira figura é 図3-1. Um documento ja junta rótulo e número sem espaço e põe um espaço ideográfico depois do número, como os livros japoneses imprimem 図3-1 「が」の二つの表し方, de modo que o estilo de legenda só escolhe a fonte e as cores. A tabela fica em 'here', sob o parágrafo que a cita. Os rótulos da figura são só latinos, U+304C e E3 81 8C: o SVG indica a fonte de código no estilo e loadSvg incorpora o arquivo da fonte antes de desenhar a imagem.
#4 · Notas por página, do jeito japonês
  footnotes: { fontSize: pt(7.5), lineHeight: pt(12), color: col('ink'),
    separator: { color: col('rule') } }, // at the column foot, 1 on each page, superscript
  // A link in a note prints its address after the text, in parentheses: the reader of the
  // printed book can type it. 'short' drops https:// and www.; the PDF keeps the full link.
  links: { print: 'inline', urlDisplay: 'short' },
As notas não pedem nenhum ajuste além do corpo: num documento japonês horizontal, os valores padrão são os que o JLReq descreve para livros horizontais, a nota no pé da coluna onde é citada, numerada a partir de 1 em cada página, com chamada sobrescrita e um fio de um terço da medida (Notas de rodapé). A chamada vem antes do ponto final, 保存していた[^hfs]。, para que o 。 nunca abra a linha seguinte separado dela.
A nota 2 cita o relatório do Unicode que define as quatro formas, e a citação é um link: [Unicode Standard Annex #15「…」](https://www.unicode.org/reports/tr15/). Uma nota não pode ter uma nota própria, então um link dentro dela imprime o endereço depois do texto, entre parênteses; links.urlDisplay: 'short' tira https:// e www., e o PDF mantém o link completo. links.print: 'inline' faz o mesmo com um link do texto (Links na edição impressa). A nota começa com palavras japonesas, para que a primeira linha se preencha antes do longo título latino.
#5 · Um título de seção de três linhas
const BAND = 74; // mm from the trim's top
const opener = { enabled: true, minHeight: pt(PITCH * 10), slot: { elements: [ // text: line 11
  { kind: 'box', id: 'band', reserve: false, style: { backgroundColor: col('tint') },
    placement: { anchor: { to: 'page', edge: 'top-left' },
      size: { width: 'fill', height: mm(BAND) } } },
  { kind: 'text', id: 'kicker', content: 'CHAPTER', fontFamily: GOTHIC, fontSize: pt(8),
    fontWeight: 700, letterSpacing: pt(1.6), color: col('teal'), align: 'left',
    placement: { anchor: { to: 'container', edge: 'top-left' }, offset: { y: mm(0) } } },
  { kind: 'text', id: 'number', content: '{numberDecimal}', fontFamily: GOTHIC, fontSize: pt(64),
    lineHeight: 1, fontWeight: 700, color: col('teal'), align: 'left',
    placement: { anchor: { to: '#kicker', edge: 'below' }, offset: { y: mm(1) } } },
  { kind: 'text', id: 'title', content: '{titleText}', fontFamily: GOTHIC,
    fontSize: pt(20), fontWeight: 700, color: col('ink'), align: 'left', overflow: 'wrap',
    placement: { anchor: { to: '#number', edge: 'below' }, offset: { y: mm(5) },
      size: { width: mm(MEASURE) } } },
] } };
A abertura do capítulo é um design sobre o H1: uma faixa verde-azulada, o número do capítulo em 64 pt vindo de {numberDecimal} e o título. Os títulos de seção usam lineSpan: 3, o 行取り (gyōdori): cada um ocupa exatamente três linhas do texto, centralizado nelas, e o texto seguinte continua no compasso da grade. headings.balancing.enabled: false impede o motor de acrescentar linhas acima dos títulos para igualar uma página.
A receita completa
// ═══ Postext Cookbook · Nº 123 · A Japanese technical manual: kana, kanji and Latin ═══
// https://postext.dev/en/cookbook/japanese-technical-manual
// Code: MIT · Text: original (CC BY 4.0) · Pictures: drawn in code
// Fonts: Noto Serif JP, Noto Sans JP, BIZ UDGothic (SIL OFL 1.1) · Needs postext ≥ 1.65.0
import {
  buildDocument, withLoadedFonts, renderPageToCanvas, defaultResourceTypes, parseTSV,
  registerResourceImage, inlineSvgFonts,
} from 'https://esm.sh/postext';
import { renderToPdf, decompressWoff2 } from 'https://esm.sh/postext-pdf';

const LANG = 'en'; // @lang: the language of the frame; the chapter is Japanese in both
const RECIPE = 'japanese-technical-manual';

// ─── 1 · Design ─────────────────────────────────────────────────────────────
// #region palette: ink, one deep teal for numbers, rules and labels, a pale tint for code
const palette = {
  ink: '#1d2327', // text: a cool near-black
  teal: '#0e5a6e', // the one accent: chapter number, heads' numbers, labels, the point box
  tint: '#e7f0f2', // the opener band, the listing's ground
  rule: '#b9c6cc', // hairlines: table rules, the note rule
  muted: '#5b666d', // running heads, folios, colophon
  paper: '#ffffff',
};
const col = (id) => ({ hex: palette[id], model: 'hex', paletteId: id });
const colorPalette = Object.entries({ ...palette, 'main-color': palette.teal })
  .map(([id, hex]) => ({ id, name: id, value: { hex, model: 'hex' } }));
// #endregion
const [MINCHO, GOTHIC, CODE] = ['Noto Serif JP', 'Noto Sans JP', 'BIZ UDGothic'];
const [BODY, PITCH] = [9, 16]; // pt: 9 pt text on a 16 pt line, 1.78 × the size
const [CHARS, LINES] = [36, 29]; // the type area in characters: 36 to a line, 29 lines
const MEASURE = CHARS * BODY * 25.4 / 72; // mm: 114.3

// #region answer: Japanese rules from the tag, written out; the quarter-em Latin space
// locale 'ja' turns on JLReq composition: kinsoku at its strictest, full-width marks squeezed
// where two meet (」、 takes one em, not two), a closing mark keeps its half em at a line
// end, 、。 may hang past it, and a paragraph opening with 「 sets the bracket in the indent.
// The values below are the ones 'auto' picks for 'ja'; they are spelled out to be seen.
const cjk = {
  lineBreak: 'ja-very-strict', // no line starts with ー, small kana, 々, 」、。?・ or :
  punctuationWidth: 'fullwidth', // 、。「」 keep their em inside the line (JLReq §3.1.2)
  hangingPunctuation: 'allow', // 、。 hang only when the line would otherwise break before them
  paragraphStartBracket: 'half', // 「 at a paragraph start sits in the indent's second half
  latinSpacing: em(0.25), // 四分アキ between kana or kanji and Latin letters or digits
  grid: { enabled: true, charsPerLine: CHARS, linesPerPage: LINES }, // whole ems, whole lines
};
// The Latin is the Japanese face's own proportional Latin, at the text's size: never
// full-width A or a second face for the words in parentheses.
const bodyText = {
O script.js montado funciona como está: cole-o como script de módulo em qualquer página ou abra a receita no CodePen. Pasta da receita no GitHub ↗ (abre em uma nova aba)
Variações
#Deixe o kana pequeno e o ー abrirem linha
ja-strict é a regra do JLReq para livros em geral: っ, ゃ e ー podem abrir linha, o que dá ao algoritmo de quebra mais pontos de corte e menos linhas espaçadas.
-  lineBreak: 'ja-very-strict', // no line starts with ー, small kana, 々, 」、。?・ or :
+ lineBreak: 'ja-strict', // small kana, ー and 々 may open a line#Sem espaço entre japonês e latim
Algumas editoras compõem as palavras latinas coladas ao kana, sem o quarto de eme.
-  latinSpacing: em(0.25), // 四分アキ between kana or kanji and Latin letters or digits
+ latinSpacing: em(0), // Unicodeでは, set solidErros comuns
Erro comum
Marque um texto japonês como 'ja', nunca com zh-Hans nem LANG
As edições de uma receita são en e es, mas uma amostra japonesa é japonesa nas duas: `locale: LANG` a marcaria como inglês ou espanhol, e uma marcação chinesa a comporia pelas regras chinesas (pontuação Kaiming, kana pequeno livre para começar linha, 图 no lugar de 図, formas chinesas dos glifos no PDF). Desde o postext 1.30 a marcação é também o idioma em que o texto é composto (em que é medido, pintado e incorporado), então qualquer marcação que não seja 'ja' dá outras formas de glifo que não as japonesas (as chinesas, sob uma marcação chinesa) e outras quebras de linha. Escreva 'ja': isso escolhe a região do Japão (quebra de linha e pontuação da JLReq, pontos de ênfase em gergelim, espaçamento dos furigana, rótulos 図 e 表) e desativa a hifenização. O lint reprova um texto com kana sob uma marcação zh ou ko. Quebra de linha em japonês (kinsoku) →
Erro comum
Componha o japonês com uma fonte japonesa
A Noto Serif SC e a TC têm kana, mas desenham os kanji com formas chinesas (直, 骨 e 角 mudam) e o kana com desenho chinês. Componha o texto em Noto Serif JP ou Shippori Mincho B1 e os títulos em Noto Sans JP, carregadas com loadCjkFonts. Os arquivos japoneses do Fontsource não têm hentaigana nem outros kana históricos (U+1B000–1B16F): loadCjkFonts falha com eles e o PDF imprime caixas, então escreva o kana moderno ou inclua nos recursos da receita uma fonte que os tenha. A Shippori Mincho também não tem as vogais com mácron ō e ū: componha o rōmaji com uma fonte latina. Kana, kanji e rōmaji →
Erro comum
Fontes chinesas são carregadas em fatias, pelo bloco cjk
O Fontsource serve uma família chinesa, japonesa ou coreana em cerca de cem arquivos por peso, cada um com um intervalo de caracteres. loadFonts baixa só o arquivo latin, então na tela os caracteres chineses vêm de uma fonte do sistema e são medidos errado, e o fontsourceProvider entrega ao PDF esse arquivo latin, que os imprime como caixas vazias. Inclua o bloco cjk do kit, chame loadCjkFonts(FONTS, markdown) depois de loadFonts (uma vez por voz, com o texto que ela compõe, quando o livro usa várias fontes CJK) e passe a renderToPdf fontProvider: cjkPdfProvider: os dois pegam os arquivos que contêm os caracteres do texto. Fontes chinesas, japonesas e coreanas →
- Uma palavra latina não pode ser quebrada dentro de uma linha japonesa, por isso uma palavra longa no fim da linha deixa a linha anterior espaçada entre os caracteres. O primeiro rascunho deste capítulo glosava os termos em inglês, 正準等価(canonical equivalence), e duas linhas saíram frouxas; os termos em inglês foram retirados onde não ajudavam o leitor.
- Escolha a fonte de código pelos caracteres que o código contém. A M PLUS 1 Code, a primeira testada aqui, não tem katakana de meia largura: a tela recorreu a uma fonte do sistema para ガイド e faltaram os glifos no PDF.
- Uma listagem se divide entre linhas de uma página para outra, com pelo menos duas linhas de cada lado (
codeStyle.splitMinLines). Na página 43, o espaço que sobra sob 3.3 não comporta o título e duas linhas, de modo que a listagem inteira abre a página 44;keepTogether: truemantém cada listagem inteira. - Numa grade de caracteres a página leva as 29 linhas, faça o que fizer um parágrafo ou uma lista na virada de página, por isso a lista das quatro formas deixaria o primeiro item, NFC, sozinho no pé da página 42.
shortListSplit: 'avoid'comshortListMaxItems: 4passa a lista inteira para a página 43, e a página 42 termina uma linha antes, acima das notas de rodapé.
Créditos
- Receita
- Ignacio Ferro
- Texto
- Texto original, CC BY 4.0
- Imagens
- Figure 3-1, the bytes of が, drawn in code in the page’s palette · Postext Cookbook · CC BY 4.0
- Fontes
- Noto Serif JP (SIL OFL 1.1) · Noto Sans JP (SIL OFL 1.1) · BIZ UDGothic (SIL OFL 1.1)
- Código
- MIT, como o Postext
Editar este texto ↗ (abre em uma nova aba)Pasta da receita no GitHub ↗ (abre em uma nova aba)