Capítol 4 · Part II · L'ofici
Partició de mots i justificació
Com talla Postext les línies, com justifica el text i com controla l’espai entre paraules amb l’algorisme de Knuth-Plass
En poques paraules
Aquesta pàgina explica com reparteix Postext les paraules al llarg de cada línia. Quan les dues vores d'un paràgraf van rectes, els espais entre paraules es poden obrir massa i queda lleig. Postext mira el paràgraf sencer abans de decidir on acaba cada línia, i així els espais queden igualats. També sap partir les paraules llargues amb un guionet al lloc correcte. Pots fixar fins on es poden obrir els espais i fer que es marquin les línies que encara queden fluixes. La pàgina també mostra com aconsegueix Postext que les columnes acabin a la mateixa alçada.
La diferència entre una composició d'aficionat i una de professional és als espais entre paraules.
Obre qualsevol novel·la de butxaca. El text és justificat: les dues vores de cada paràgraf estan perfectament alineades. Però mira-ho més de prop. Els espais entre paraules són gairebé uniformes, línia rere línia. No hi ha rius d'espai en blanc que baixin per la pàgina. No hi ha línies amb dues paraules perdudes en un oceà de blanc. Aconseguir-ho és molt més difícil del que sembla, i és el problema tipogràfic que més esforç d'enginyeria ha consumit en la història.
Postext ho resol amb el mateix algorisme que TeX fa servir des de 1981: Knuth-Plass per al tall òptim de línies. Amb patrons de partició de mots de qualitat TeX, límits configurables de l'espai entre paraules i un sistema visual de depuració per identificar les línies problemàtiques, el motor produeix text justificat de qualitat editorial.
#El problema
Quan el text es configura amb textAlign: 'justify', cada línia excepte l'última s'ha d'estirar o comprimir per omplir exactament l'amplada de la columna. El motor distribueix la diferència entre l'amplada natural del contingut i l'amplada de la columna entre els espais entre paraules d'aquella línia. (L'última línia es deixa en bandera, a la seva amplada natural, amb una excepció que s'explica a L'última línia.)
Si una línia té moltes paraules, cada espai absorbeix un ajust mínim, invisible per al lector. Però si una línia té poques paraules (perquè una paraula llarga ha forçat un tall prematur), cada espai s'ha d'estirar molt. El resultat és una línia fluixa: una línia on l'espai entre paraules és tan ample que trenca el ritme de lectura i crea forats visuals lletjos.
El problema oposat també existeix. Si el motor encabeix massa paraules en una línia, els espais es comprimeixen per sota de la seva amplada natural, i en surt una línia atapeïda, on les paraules semblen amuntegades.
Un algorisme de tall de línies ingenu, com el que fa servir CSS, pren decisions línia per línia. Omple la línia actual amb tantes paraules com pot, talla i continua. Aquest enfocament voraç de primer ajust té una feblesa de fons: no pot veure el futur. Una decisió que sembla òptima per a la línia 5 pot forçar la línia 6 a un tall terrible. Quan l'algorisme arriba a la línia 6, ja és massa tard: la línia 5 ja és definitiva.
#Knuth-Plass: veure el paràgraf sencer
L'algorisme Knuth-Plass, publicat per Donald Knuth i Michael Plass el 1981, adopta un enfocament radicalment diferent. En lloc de tallar una línia cada vegada, considera totes les maneres possibles de tallar el paràgraf sencer i tria la combinació que minimitza la «lletjor» total de totes les línies. És l'algorisme que fa servir TeX, i és la raó per la qual els documents compostos amb TeX han estat la referència del text justificat durant més de quatre dècades.
#El model Caixa-Cola-Penalització
Knuth-Plass no pensa en termes de paraules i espais. Modela el text com una seqüència de tres primitives:
| Primitiva | Representa | Comportament |
|---|---|---|
| Caixa (Box) | Una paraula o un fragment de text | Té una amplada fixa. No es pot estirar, ni comprimir, ni tallar. |
| Cola (Glue) | Espai entre paraules | Té una amplada natural, una capacitat d'estirament i una capacitat de compressió. El motor pot ajustar la cola dins d'aquests límits per omplir la línia. |
| Penalització (Penalty) | Un punt de tall potencial | Té un cost. Penalització baixa = tall barat. Penalització alta = tall car. Una penalització marcada (flagged) indica un punt de partició de mots (afegeix un guionet visible si es fa servir). |
Un paràgraf es converteix en una seqüència com aquesta:
[caixa "La"] [cola] [caixa "guineu"] [cola] [caixa "ràpida"] [cola] [caixa "marró"]
[penalització -∞]  ← tall forçat al final del paràgraf
Quan la partició de mots és activa, les paraules llargues es divideixen en fragments separats per penalitzacions:
[caixa "ti"] [penalització 50, marcada] [caixa "po"] [penalització 50, marcada] [caixa "grafia"]
Cada penalització marcada té un cost de 50: no és gratuïta, però és més barata que produir una línia fluixa.
#Com troba l'òptim
L'algorisme fa servir programació dinàmica. Manté un conjunt de nodes actius (punts de tall possibles on podrien començar línies noves) i avalua cada tall viable des de cada node actiu. Per a cada tall candidat, calcula:
-
Ràtio d'ajust (r): quant s'ha d'estirar o comprimir la cola en aquesta línia.
r = 0vol dir que la línia encaixa perfectament.r > 0vol dir estirament (fluixa).r < 0vol dir compressió (atapeïda). -
Lletjor (badness): una mesura de com és de desigual l'espaiat, calculada com
100 × |r|³. El creixement cúbic fa que una línia lleugerament fluixa sigui tolerable, però una de molt fluixa es penalitza severament. Una línia ambr = 2té lletjor 800; una ambr = 0.5té lletjor 12. -
Classe d'ajust (fitness class): cada línia es classifica com a atapeïda (
r < -0.5), normal (-0.5 ≤ r < 0.5), fluixa (0.5 ≤ r < 1.0) o molt fluixa (r ≥ 1.0). Si una línia atapeïda és al costat d'una de molt fluixa, el contrast molesta; per això es penalitzen les línies adjacents amb classes que disten més d'un pas. -
Demèrits (demerits): el cost total de tallar aquí. Com a TeX, la lletjor i la penalització del punt de tall es combinen en una fórmula quadràtica:
deméritos = (1 + fealdad + penalización)²quan la penalització no és negativa; una penalització negativa (un tall desitjable) en canvi resta el seu quadrat:(1 + fealdad)² − penalización². Després s'hi sumen dos demèrits plans:- Demèrit per guionets consecutius (per defecte 3000): penalitza dues línies seguides amb guionet, perquè els guionets apilats molesten visualment.
- Demèrit per classe d'ajust (per defecte 100): s'hi afegeix quan la classe d'ajust d'aquesta línia dista més d'un pas de la de la línia anterior.
La penalització per línia curta descrita més avall també entra en aquesta fórmula, injectada com a lletjor addicional; les penalitzacions d'òrfenes i vídues actuen en una etapa posterior, quan un paràgraf es divideix entre columnes.
L'algorisme tria la seqüència de talls amb els demèrits totals més baixos de tot el paràgraf: aquí és on supera l'algorisme voraç.
L'algorisme recorre enrere els nodes actius per trobar el camí amb els demèrits totals més baixos, és a dir, el conjunt de punts de tall globalment òptim per a tot el paràgraf.
Penalitzacions d'òrfenes, vídues i línies curtes
Postext amplia el model de costos estàndard amb tres penalitzacions editorials que allunyen el motor de composicions amb finals de paràgraf i de columna poc afortunats:
- La penalització d'òrfena s'aplica quan una divisió candidata deixaria menys de
orphanMinLineslínies a la part superior de la columna següent. El valor per defecte d'orphanPenaltyés1000. - La penalització de vídua s'aplica quan la divisió deixaria menys de
widowMinLineslínies al final de la columna actual. El valor per defecte dewidowPenaltyés1000. - La penalització per línia curta final (el runt de la tipografia anglesa) s'aplica quan l'última línia del paràgraf seria més curta que aproximadament
runtMinCharacters × normalSpaceWidthpíxels (un recompte d'espais entre paraules, no de lletres): el valor per defecte, 20, equival a una última línia d'unes 8 a 12 lletres. El valor per defecte deruntPenaltyés1000, el mateix per a tota línia curta; ambgradedRuntPenaltyes gradua segons el que li falta a la línia,runtPenalty × (1 − ancho / umbral), de manera que un final de dues paraules costa menys que un d'una i guanya quan una línia de dalt pot cedir una paraula. A diferència de les penalitzacions d'òrfenes i vídues (que se sumen linealment al demèrit del tall), la penalització per línia curta final entra com una badness equivalent dins de la fórmula quadràtica de Knuth–Plass, de manera que competeix a la mateixa escala que la badness de línia (que se satura a 10000) en lloc de quedar-ne eclipsada.
Quan la penalització no basta (perquè cap tall alternatiu no és viable), el motor fa el que faria un caixista a mà: compon el paràgraf amb una línia menys (tightenRunts). Els espais de totes les línies s'estrenyen, mai per sota de minWordSpacing, i si amb això no n'hi ha prou per pujar les paraules soltes hi entra a més una mica de tracking negatiu, l'escaló més petit que funcioni i mai més de maxRuntTracking mil·lèsimes d'em. La composició més curta també ha de respectar maxWordSpacing. Ficar les paraules en una línia menys estreny gairebé totes les línies, però pot moure un tall de manera que una altra línia s'hagi d'estirar molt. Si una composició estira una línia més enllà de maxWordSpacing o, si el paràgraf ja té una línia més oberta, més que aquella línia, no serveix com a solució, i la línia curta es queda. Només compten les línies que continuen justificades: una línia que el paràgraf compon en bandera perquè passa de 3 vegades l'espai normal (vegeu Línies que l'algorisme no pot omplir) no fa pujar el llistó, i la composició més curta no pot compondre en bandera més línies que el paràgraf. Tampoc no canvia una línia en bandera per línies justificades que passin d'aquest llistó: el paràgraf conserva la seva línia en bandera i la seva línia curta. L'equilibratge de columnes segueix la mateixa regla en sentit contrari: un paràgraf que s'havia de compondre amb una línia més per omplir una columna curta es deixa com estava si aquella línia de més acabés en una línia curta final; omplir una columna no justifica deixar una síl·laba sola.
Un bloc compost així, amb una línia menys, ho indica: VDTBlock.runtFix conté { tracking }, el tracking negatiu aplicat en mil·lèsimes de quadratí, o 0 quan n'hi ha hagut prou amb els espais entre paraules. Cap renderitzador no el llegeix; és per a qui ajusta el text, perquè un paràgraf compost al límit es veu atapeït al costat dels veïns, i amb unes quantes paraules menys s'hauria compost sense tracking.
La penalització per línia curta final se suma als demèrits del node candidat dins de l'algorisme de tall de línies, així que l'algorisme pot sacrificar una línia una mica més fluixa a canvi d'una línia final més llarga, però només dins de maxWordSpacing: una línia estirada més enllà d'aquest límit rep una badness addicional més gran que qualsevol penalització per línia curta o per guionet, de manera que l'algorisme prefereix una última línia curta, o una última paraula partida, abans que un espai entre paraules que superi el límit. Les penalitzacions d'òrfenes i vídues entren en una optimització a part que s'executa quan un paràgraf passa d'una columna a l'altra: cada tall candidat rep una puntuació (la suma dels demèrits de l'espai sobrant, de les òrfenes i de les vídues) i guanya el tall més barat, de manera que el motor preferirà de forma natural divisions que evitin totes dues sempre que sigui possible. Ajusta el compromís amb orphanPenalty, widowPenalty o runtPenalty; posar-ne qualsevol a 0 desactiva aquella regla, i avoidOrphans, avoidWidows i avoidRunts (totes true per defecte) apaguen una regla sencera. Els elements de llista s'hi apunten amb avoidOrphansInLists, avoidWidowsInLists i avoidRuntsInLists (tots a true per defecte). Aquestes regles mantenen juntes les línies d'un element; shortListSplit manté junts els elements d'una llista curta (desactivat per defecte, vegeu Text de cos).
#Per què importa
La diferència es veu a la pràctica. En una composició voraç, trobaràs paràgrafs on una línia és notablement més fluixa que les veïnes, i si t'hi fixes bé, veuràs que ha passat perquè la línia anterior ha agafat una paraula de més. Knuth-Plass ho evita canviant una línia actual lleugerament pitjor per una de següent molt millor, perquè pot veure'n les conseqüències.
#Implementació de Postext
Postext implementa l'algorisme de Knuth-Plass complet al mòdul knuthPlass/ del paquet principal: un nucli de programació dinàmica (nodes actius, demèrits, recorregut cap enrere) i dos adaptadors que converteixen el text al model caixa-cola-penalització:
- Adaptador de text sense format: fa servir
@chenglou/pretextper mesurar el text sense DOM. Pretext proporciona amplades de segment i amplades de guionets discrecionals; Postext les converteix en elements KP. - Adaptador de text amb format: gestiona trams en negreta i cursiva i els mesura amb Canvas. Cada token amb estil es converteix en una o més caixes, amb punts de partició de mots inserits com a penalitzacions.
El nucli de programació dinàmica existeix dues vegades i totes dues versions trien els mateixos talls: en TypeScript i, des de postext 1.33, en Rust compilat a WebAssembly, que respon per defecte i és més ràpid. El de TypeScript respon fins que el mòdul està compilat i allà on WebAssembly no està disponible, de manera que quin dels dos ha compost un paràgraf no canvia mai la composició (vegeu El separador de línies (WebAssembly)).
Tots dos adaptadors calculen el justifiedSpaceRatio de cada línia: l'amplada a què es pinta cada espai de la línia, dividida per l'espai de la rodona. Tots els espais d'una línia es pinten igual, vinguin de l'estil que vinguin. Els límits fiten una cosa una mica diferent, el canvi de cada espai respecte de la seva pròpia amplada, comptat en espais de rodona, i un espai en cursiva o en negreta és més estret o més ample que el de la rodona. Per això una línia que en conté algun es pinta una mica per sota de minWordSpacing o per sobre de maxWordSpacing tot i que es va tallar dins d'aquests límits, i porta a més justifiedSpaceLimitRatio, el nombre que fiten els límits: 1 més l'excedent de la línia dividit pels seus espais, cadascun amb la seva pròpia amplada. lineWordSpacing(line) retorna aquest nombre, o justifiedSpaceRatio en una línia amb tots els espais de rodona, on tots dos coincideixen. Alimenta el sistema de depuració de línies fluixes descrit més endavant; la maquetació en si (el pas a bandera, la correcció de les línies curtes finals, la palanca dels paràgrafs fluixos) continua llegint la proporció pintada. Les proporcions només es calculen per a les línies que no són finals; com es compon la línia final s'explica a L'última línia.
Al voltant de l'algorisme de tall de línies, la mesura del text és al mòdul measure/ (la mesura de text sense format i amb format, les mètriques de glifs amb Canvas i la gestió de les cadenes de font), darrere d'una memòria cau de mesures explícita. Quan arriben o desapareixen les variants d'una família, el motor descarta el que ha mesurat en aquella família, tant a les seves memòries cau d'amplades com a la memòria cau de mesura que guardi l'amfitrió, de manera que les mesures continuen sent precises després que les fonts web acabin de carregar-se sense que l'amfitrió hagi de buidar res (vegeu Carregar les fonts abans de compondre). L'anàlisi sintàctica, l'etapa que converteix el text font en blocs i trams en línia, és al mòdul parse/. Consulta la pàgina d'Arquitectura per veure l'organització a nivell de fitxer d'aquests mòduls.
El tall de línies també interactua amb els tipus de contingut més recents. Els recursos flotants ocupen la banda superior o inferior d'una columna o pàgina, i escurcen els trams de columna als quals reaccionen les penalitzacions d'òrfenes, de vídues i d'espai sobrant (slack). Els peus i les cel·les de taula es mesuren com a text amb format que es parteix en línies, amb les fonts dels peus i de les taules. Les fórmules en bloc es centren i són indivisibles: no es justifiquen ni es tallen mai. Consulta Format de document › Recursos i Configuració › Estil de taules / Estil de peus de recurs per a més detall.
Comportament de reserva: si Knuth-Plass no produeix talls vàlids (cosa que pot passar amb columnes extremadament estretes o paraules més llargues que l'amplada de columna), el motor recorre al tall voraç de Pretext (layoutNextLine()). Això garanteix que la composició sempre es completi.
#Partició de mots
La partició de mots i la justificació són inseparables. Sense partició de mots, l'única manera que té el motor d'evitar una línia fluixa és passar una paraula a la línia següent, i sovint això només desplaça el problema. La partició de mots dona al motor un conjunt molt més gran de punts de tall, i millora molt la qualitat del text justificat.
#Patrons de qualitat TeX
Postext fa servir Hypher (hypher v0.2.5) per a la partició de mots, alimentat per patrons de partició TeX/Liang. Són els mateixos patrons que TeX fa servir des de 1983: una representació compacta de les regles de separació sil·làbica, obtinguda amb l'algorisme de generació de patrons de Frank Liang a partir de grans corpus de paraules.
Els patrons codifiquen un conjunt de regles numerades que, superposades sobre una paraula, indiquen on es permeten els talls (nombres senars) i on es prohibeixen (nombres parells). Els paràmetres leftmin i rightmin del fitxer de patrons de cada llengua asseguren un nombre mínim de caràcters abans i després de qualsevol punt de tall. Per a l'anglès (en-us), normalment són 2 i 3 respectivament: una paraula ha de tenir com a mínim 2 caràcters abans del guionet i 3 després.
#Llengües compatibles
| Codi de llengua | Llengua |
|---|---|
'en-us' | Anglès (EUA) |
'es' | Castellà |
'fr' | Francès |
'de' | Alemany |
'it' | Italià |
'pt' | Portuguès |
'ca' | Català |
'nl' | Neerlandès |
Cada llengua carrega el seu propi conjunt de patrons. Les instàncies de Hypher es creen només quan cal i es desen a la memòria cau: la primera crida per a una llengua paga el cost d'inicialització, i les següents són instantànies. Una etiqueta amb regió fa servir els patrons de la seva llengua ('es-ES' es parteix amb 'es', i 'en-GB', amb 'en-us'). Una llengua sense patrons inclosos fa servir els d'en-us, i el motor en dona un avís una vegada a la consola (vegeu Partició de mots a la referència de configuració). El xinès, el japonès i el coreà són l'excepció: es componen sense partició de mots i sense l'avís, i les seves línies es tallen entre caràcters (vegeu Xinès, japonès i coreà més avall).
El català segueix les normes de l'Institut d'Estudis Catalans (Llibre d'estil, capítol VI). S'apliquen des de postext 1.14:
- Cada tall deixa com a mínim dues lletres a cada costat (
ter-ra,cai-xa,plu-ja). - La ela geminada es talla entre les dues l, i el guionet ocupa el lloc del punt volat: il·lusió queda
il-|lusió. La línia es mesura sense el punt, així que la justificació i Knuth–Plass en veuen l'amplada real. - Dues vocals en hiat no se separen (
cièn-cia,ca-mions). Una i o una u entre vocals compta com a consonant i obre la seva síl·laba (fe-ia,ve-ient). - No es talla just després d'un apòstrof (
s'ha-via, mais'-havia). L'anglès, el francès i l'italià tenen regles pròpies per a l'apòstrof (vegeu Partició de mots). - Les paraules amb prefix més comunes es tallen pel prefix (
vos-altres,cel-obert,ben-estar). - Perquè les paraules amb pronoms enclítics només es tallin pel seu propi guionet (
portar-|lo), com prefereix l'IEC, posahyphenation.compoundsafalse.
#Per què Hypher (i no un algorisme propi)
El sistema original de partició de mots de Postext feia servir una heurística pròpia basada en vocals: detectava els límits entre síl·labes buscant grups de vocals, prefixos comuns (over-, under-, inter-) i sufixos comuns (-tion, -ment, -sion). Era simple i ràpida, però limitada de base:
| Aspecte | Heurística pròpia | Hypher (patrons TeX) |
|---|---|---|
| Precisió | Bona per a paraules comunes, poc fiable per a les inusuals. La detecció per vocals omet molts punts de tall vàlids i en crea d'invàlids. | Gairebé perfecta. Els patrons es generen a partir de grans corpus i s'han refinat durant més de 40 anys. |
| Cobertura lingüística | Calia definir a mà conjunts de vocals, prefixos i sufixos per a cada llengua, una feina feixuga i propensa a errors. | Hi ha fitxers de patrons per a més de 50 llengües, mantinguts per la comunitat TeX. Afegir una llengua és afegir un import. |
| Estàndard de la indústria | No és un estàndard reconegut. Sense eines ni suport de la comunitat. | Els mateixos patrons que fan servir TeX, LibreOffice, Firefox, Chrome i pràcticament tots els sistemes de composició professional. |
| Manteniment | Cada cas especial és un error que cal arreglar a mà. | Fitxers de patrons mantinguts per la comunitat. Les correccions arriben del projecte original. |
| Mida del codi distribuït | ~170 línies, sense dependències. | El nucli de Hypher fa ~3 KB. Cada fitxer de patrons d'una llengua hi afegeix 20–80 KB (amb gzip: 5–20 KB). Les vuit llengües incloses sumen aproximadament 300 KB (amb gzip: ~80 KB). |
| Rendiment | Molt ràpida (escaneig simple de cadenes). | Ràpida (cerca en un trie, caràcter a caràcter). A la pràctica, insignificant: la partició de mots no és mai el coll d'ampolla. |
El compromís és clar: una mida més gran a canvi d'una correcció molt millor i cap càrrega de manteniment. Per a un motor de composició orientat a la qualitat editorial, la correcció guanya. Una sola partició de mots incorrecta en un llibre imprès és més cara que uns quants kilobytes extra de patrons.
#Com s'integra la partició de mots amb Knuth-Plass
Abans que el text entri a l'algorisme Knuth-Plass, el motor el preprocessa amb Hypher i insereix guionets tous (Unicode \u00AD) a cada punt de tall legal. Després, aquests caràcters invisibles es converteixen en penalitzacions KP amb un cost de 50 i flagged: true.
L'algorisme tracta els talls per partició de mots com una opció més per avaluar al costat dels límits naturals de paraula (on la cola permet un tall). Si fer servir un guionet produeix uns demèrits totals menors que deixar la línia fluixa, l'algorisme agafa el guionet. Si no, deixa la paraula intacta.
El demèrit per guionets consecutius (per defecte 3000) fa que l'algorisme eviti amb força posar guionets en dues línies adjacents, una convenció tipogràfica que imposen pràcticament totes les guies d'estil.
Un guionet a l'última línia d'una columna o d'una pàgina envia el lector a la columna següent a mitja paraula. bodyText.hyphenateAcrossColumns: false l'aparta d'aquestes línies: quan la línia que tanca una columna acaba en guionet, el paràgraf es torna a tallar amb un guionet allà penalitzat com una línia curta, de manera que l'algorisme acaba aquella línia en una paraula sencera sempre que els espais entre paraules de les línies de dalt puguin absorbir la diferència dins de maxWordSpacing i minWordSpacing. On no poden, el guionet es queda. S'aplica al primer salt de columna de cada paràgraf i als següents que cauen on acaba una columna plena. Un salt posterior que cau en un altre lloc (una columna escurçada per evitar una vídua, una banda de tancament anivellada) rep un nou tall a partir d'aquella columna: les línies ja col·locades a les columnes anteriors conserven els seus talls, i només es torna a tallar la resta del paràgraf. Així el guionet només es queda on cap tall dins dels límits no l'evita, a la pràctica al primer salt de columna d'un paràgraf. hyphenateAcrossColumns: 'withinPage' limita la protecció a les línies que tanquen una pàgina: el lector que gira el full, o que passa a la pàgina enfrontada, troba una paraula sencera, mentre que una paraula partida entre dues columnes de la mateixa pàgina es deixa tal com és. Amb tres columnes això deixa en pau dos de cada tres finals de columna, de manera que es tornen a tallar menys paràgrafs i menys línies prenen espais més amples o més estrets per pagar-ho. L'algorisme distingeix les maneres d'arribar a una línia només fins a l'última línia que protegeix, així que un reintent costa més o menys el que la primera mesura: una mesura més per cada paràgraf que es torna a tallar.
Per defecte, la partició de mots només s'aplica quan bodyText.hyphenation.enabled és true i bodyText.textAlign és 'justify': una vora en bandera està pensada per ser irregular. El text en bandera també es pot partir, amb bodyText.hyphenation.ragged: true. Una línia en bandera no té espais entre paraules per igualar, així que ho decideix una zona de partició: una paraula que no hi cap només es parteix si, en passar-la sencera a la línia següent, quedaria un forat més gran que hyphenation.zone (3 em per defecte). Knuth-Plass també compon el text corregut en bandera (bodyText.optimalRagged, activat per defecte): els seus espais entre paraules no canvien d'amplada, cada línia paga pel que li falta respecte de la mesura i la zona decideix quines síl·labes pot agafar; dos finals de línia seguits en síl·laba costen el que dos guionets seguits. Línia a línia (optimalRagged: false), mai no acaben més de dues línies seguides en síl·laba. Vegeu Text en bandera.
Hi ha oportunitats de tall que no depenen d'aquest paràmetre. Un guionet entre dues lletres (enseñanza-aprendizaje, físico-química) és un punt on la línia pot acabar: la paraula ja porta el guionet, així que no s'hi afegeix res. Knuth-Plass el té en compte en tot paràgraf amb bodyText.breakAfterHyphens (activat per defecte), amb el preu d'una síl·laba; en un paràgraf justificat sense format en línia, només amb dues lletres a cada costat del guionet, perquè cap línia no acabi en la e- d'e-mail. Si es desactiva, com fins a postext 1.4, un paràgraf justificat sense format en línia no talla just després d'aquest guionet, mentre que el mateix paràgraf amb una paraula en cursiva en qualsevol lloc sí que ho fa; els llibres desats abans de postext 1.5 es llegeixen amb l'opció desactivada. La línia acaba en el guionet del mateix text, que la línia anota com a hardHyphen al costat de hyphenated, de manera que qui elimina un guionet afegit (les capçaleres, el cursor del Sandbox) conserva aquest. Una ratlla o un guió mitjà enganxats a dues paraules (Madrid–Barcelona, I.—Que trata o, en anglès, say—that’s) també són un punt on la línia pot acabar, amb tots dos algorismes, gràcies a bodyText.breakAfterDashes (activat per defecte): la línia acaba en el guió, no s'hi afegeix res i no costa res. També ho són una ratlla o un guió mitjà que tanquen un tram d'un estil davant d'una paraula en un altre (calidad–*precio*). La línia queda llavors com a hyphenated, sense hardHyphen. Mai després del guió que obre un incís o un diàleg (—dijo, dijo "—Hola; unes cometes que tanquen una paraula sí que poden anar davant del guió, com a «no»—y o en l'alemany „nein“—und), davant d'un signe de puntuació, davant d'unes cometes o d'un parèntesi (pensaba—» y, dijo—«no»), dins d'una sèrie de guions ni dins d'un interval de nombres (1914–1918). I una paraula més ampla que tota la mesura (una cel·la estreta de taula, un compost llarg en una columna estreta) no es deixa sobresortir mai: el motor la parteix per l'última síl·laba que hi cap, amb guionet, o per l'últim caràcter que hi cap quan el diccionari no hi ofereix cap síl·laba. Un tall al costat d'un guionet que ja porta la paraula cau darrere d'aquest guionet i no n'afegeix un altre, així que la paraula mai no en mostra dos. La resta de la paraula conserva els seus propis punts de tall: un compost continua tallant-se pels seus guionets i una adreça web per les seves juntures, mentre que fins a postext 1.4 la resta es partia per les síl·labes del diccionari. Un paràgraf sense format en línia es talla per l'últim caràcter que hi cap, sense guionet, tret que es parteixi per síl·labes. Per a Knuth-Plass cap conjunt de talls al voltant d'una paraula així no és viable, de manera que un paràgraf justificat que la conté es compon línia a línia. Els nombres en són l'excepció (des de postext 1.82): vegeu Dins d'un nombre més avall.
Aquest tall s'avisa (des de postext 1.52): una paraula tallada entre dues de les seves lletres com a avís wordDividedByCharacter, una dividida per una síl·laba com a nota wordDividedBySyllable, amb el text de la línia. La línia ho registra com a wordDivided ('character' o 'syllable'). Val també per als titolets, les obertures i els marcs d'una pàgina composta, on la causa habitual és un marc estret: dona més espai al text o redueix el cos. Un tall en un espai de no separació no divideix cap paraula i no s'avisa.
Una barra entre dues paraules (entrada/sortida, ACC/AHA/AAPA) també és un punt on pot acabar una línia de text amb format, amb bodyText.breakAfterSlashes (activat per defecte des de postext 1.53): la línia acaba a la barra i la següent comença amb la paraula que la segueix; no s'hi afegeix res ni es penalitza. Cada costat de la barra ha de tenir almenys tres lletres o xifres seguides, i no poden ser dues xifres, de manera que una unitat (km/h, kg/m³, mg/dL), un parell curt (i/o), una fracció i una data (1/2, 10/03/2026) no se separen. Una paraula més ampla que tota la seva mesura es divideix després d'una barra abans que en una síl·laba o entre dues lletres, després de qualsevol barra llevat de la // d'una adreça web, i aquest tall no es notifica. Un espai d'amplada zero (U+200B) escrit al text també és un tall: la línia hi pot acabar, no s'hi afegeix res i el caràcter no arriba al text de la línia. Un paràgraf sense format en línia talla després de qualsevol barra, on la marca el diccionari de partició de mots, sigui quin sigui el paràmetre. Les configuracions desades abans de configVersion 19 es llegeixen amb breakAfterSlashes: false, els talls de postext 1.51, que només acabava una línia amb format després d'una barra dins d'una adreça web.
#Paraules compostes
Un compost unit per guionet (teórico-práctico, físico-química) es pot tallar en dues menes de lloc: després del seu propi guionet i a les síl·labes del diccionari de qualsevol de les seves parts (teó-rico-práctico). TeX, i el Chicago Manual of Style, deixen senceres les parts i només tallen un compost pel guionet. bodyText.hyphenation.compounds: false fa el mateix: el diccionari no toca cap paraula amb un guionet entre dues lletres, que així només es talla després d'aquest guionet. Un guionet tou escrit entre dues lletres de la paraula continua permetent el tall, i un compost més ample que tota la línia es continua partint on calgui. El valor per defecte, true, continua partint les parts, cosa que dona a una columna justificada estreta més maneres d'omplir les seves línies.
L'ortografia portuguesa demana repetir al començament de la línia següent el guionet d'un compost tallat a final de línia (vencer- · -se), i també les normes de la Real Academia Española des de 2010 (léxico- · -semántico), perquè qui llegeix sàpiga que el guionet és de la paraula. bodyText.repeatHyphen: true ho fa. El guionet repetit es mesura amb la seva línia, així que l'algorisme li deixa lloc, i es pinta com la resta del text; al PDF porta un text de substitució que l'omet, de manera que el text que es copia o s'extreu del PDF llegeix la paraula una sola vegada (vencer-se). La línia l'anota com a repeatedHyphen, i el seu plainStart i el seu sourceStart apunten darrere seu, de manera que el mapa del text font, els enllaços i les capçaleres llegeixen la paraula tal com està escrita. Una adreça web no el porta mai. S'aplica al text corregut, als encapçalaments, a les llistes, a les cites i als requadres; un paràgraf sense format que conté un compost es talla aleshores amb l'algorisme del text amb format.
#Mots que no es divideixen
Al diccionari se li pot demanar que deixi en pau certes paraules. bodyText.hyphenation.exceptions les llista una per una: 'Alice' no es divideix mai, 'You-Tube' només pel guionet de la seva entrada, com en el \hyphenation{…} de TeX. bodyText.hyphenation.capitalized: false deixa sencera tota paraula que comença amb majúscula, i citations.hyphenateNames: false, els cognoms dels autors que el document cita. L'algorisme té aleshores menys llocs on acabar una línia: on abans un nom quedava partit, la línia anterior rep més o menys espai entre paraules, dins de minWordSpacing i maxWordSpacing. Una paraula més ampla que tota la mesura es continua partint. Vegeu Mots que no es divideixen per saber com es compara una entrada amb el text.
#On no es talla mai una línia
Hi ha llocs que no són mai un punt de tall, amb cap dels dos algorismes:
- Un espai de no separació. U+00A0, l'espai fi de no separació U+202F i l'espai de xifra U+2007 uneixen les paraules de tots dos costats: un nombre i la seva unitat, una referència de pàgina, un grup de milers. El mateix val per als peus, les cel·les de taula, els requadres i el text de disseny (capçaleres, obertures). Cadascun conserva la seva pròpia amplada, tal com es mesura; la justificació només estira els espais entre paraules. Una font sense glif per a U+202F o U+2007 els dona l'amplada que els donen els navegadors, la meitat d'un espai entre paraules i la d'una xifra, en totes les sortides, PDF inclòs; pràcticament totes les fonts tenen U+00A0. L'excepció és un grup unit així que és més ample que tota la línia, tingui format en línia o no: es talla en el seu últim espai de no separació, en lloc de partir-se dins d'una paraula. L'unidor de paraules U+2060 uneix sense ocupar lloc, també en text xinès: dos caràcters amb un entre ells es queden a la mateixa línia. (Un número en cercle com ① no el necessita: des de postext 1.25 el text xinès el manté amb el caràcter següent.) També U+FEFF, l'espai de no separació d'amplada zero, encara que el caràcter pensat per a això és l'unidor de paraules.
- Un rètol de referència amb número. Una referència en línia que imprimeix un número o una pàgina (
secció 3.2,pàg. 112,Fig. 1.7,Teorema 2) és una sola paraula: cap línia no es talla entre la seva paraula i el seu número, sigui quin sigui l'espai de la plantilla, i el seu espai no s'estira. Una referència que imprimeix paraules (el text d'una àncora, un encapçalament, untext="…"propi) és diferent des de postext 1.28: es talla pels seus propis espais, que s'estiren amb la línia (crossRefs.breakLabels); les seves paraules continuen sense partir-se mai amb guionet. - Text que es toca. Una paraula en negreta o cursiva i la puntuació que la segueix (
**ósmosis**.), els parèntesis que envolten una remissió en línia ((:ref{id="fig-3"})), una paraula composta en dos trams: el text sense cap espai entremig és una sola unitat, com si fos una paraula. Quan aquesta unitat no cap en el que queda de línia, baixa sencera. Quan obre una línia i tot i així no hi cap, la seva última paraula es parteix per una síl·laba perquè la puntuació baixi amb el final de la paraula; només una unitat sense síl·laba per on partir deixa que la seva puntuació obri la línia següent. - En un guionet tou sense lletra en un dels costats. Un guionet tou (U+00AD) escrit al text només és un punt de tall entre dues lletres o xifres: escrit entre
toigether, deixa que una línia acabi ento-. Escrit a la vora d'una paraula, després d'un parèntesi o d'unes cometes d'obertura, o davant de la puntuació de tancament, no talla res ni imprimeix res, de manera que cap línia no acaba en un guionet després d'una paraula sencera. I com que el diccionari no toca la paraula que ja té un guionet tou, un guionet tou davant de la primera lletra manté sencera aquella aparició de la paraula, en qualsevol llengua: amb un davant de laA,Aliceno es parteix mai. InDesign escriu així el seu guionet discrecional, i el text que se n'exporta en conserva el sentit. Fins a postext 1.27, aquest guionet tou era un punt de tall com qualsevol altre (said Alice-), i en català la resta de la paraula es continuava partint. - Dins d'un nombre. Un nombre no es parteix mai com una paraula, ni per una síl·laba ni entre dues de les seves xifres (des de postext 1.82):
3,60-damunt de0es llegeix com dos nombres. Un nombre és una paraula que comença amb una xifra, després d'un parèntesi o d'unes cometes d'obertura, un signe o un símbol de moneda si n'hi ha, i només conté xifres (de qualsevol escriptura) i els signes que les agrupen i les separen (.,'’, l'espai de no separació, l'espai fi de no separació i l'espai fi, els separadors àrabs), amb un exponent, una unitat unida directament o amb un espai de no separació (kg,km/h,°C,%, lasde1990s) i la puntuació de tancament:3,600,−12.5,(€1,250.00),37 °C. Una data o un interval (2026-11-13,1914–1918) i una paraula amb una lletra davant de la primera xifra (COVID-19) no són nombres. Un nombre més ample que la seva línia, normalment en una columna estreta d'una taula, un peu o una nota, sobresurt sencer de la mesura, tant si el text es parteix per síl·labes com si no, i la construcció en dona un avís de contingutnumberOverflowamb el nombre i, en un peu, una nota o una cel·la de taula, el recurs i la part on és (la fila i la columna de la cel·la). Només es parteix en un espai de no separació entre els seus grups, on no s'afegeix res: escriu4 356 000amb U+202F o U+00A0 perquè una xifra llarga pugui passar de línia. Si no, eixampla la columna (el seu pes acolumnWidths) o redueix el cos del text. Fins a postext 1.81 un nombre així es tallava per caràcters amb un guionet afegit (3,60-|0) i s'avisava com awordDividedByCharacter. - Dins d'una paraula d'escriptura lligada. Una paraula àrab (o siríaca, n'ko o mongola) no es parteix mai amb guionet, ni tan sols en un guionet tou escrit a dins, ni es talla entre les seves lletres: les seves lletres van lligades, i un tros compost a part prendria altres formes i una altra amplada. L'àrab i les altres llengües de dreta a esquerra tenen la partició de mots desactivada per defecte; si s'activa (per a les paraules llatines d'un llibre àrab, o en un llibre en català que cita en àrab), el diccionari se salta aquestes paraules. Una paraula en dos estils (
كتا**ب**) continua sent una sola paraula, que es mesura sencera. Si és més ampla que tota la línia, sobresurt de la mesura i la construcció en dona un avís (unbreakableWordOverflow).
Fins a postext 1.4, un paràgraf amb format en línia o amb un :ref es podia tallar en un espai de no separació, i una línia en bandera podia acabar en el ( que precedeix una remissió o començar amb el punt que segueix una negreta.
#Límits d'espaiat entre paraules
El model de cola dona al motor límits explícits sobre quant es poden estirar o comprimir els espais entre paraules. Aquests límits es controlen amb dues propietats de configuració a bodyText:
| Propietat | Per defecte | Descripció |
|---|---|---|
maxWordSpacing | 2 | Límit superior de l'espaiat entre paraules, com a multiplicador de l'amplada normal de l'espai. Amb el valor per defecte, els espais es poden estirar fins al 200% de la seva amplada natural. |
minWordSpacing | 0.6 | Límit inferior de l'espaiat entre paraules, com a multiplicador de l'amplada normal de l'espai. Amb el valor per defecte, els espais es poden comprimir fins al 60% de la seva amplada natural. |
Aquests multiplicadors es tradueixen directament als valors de stretch i shrink de la cola en el model Knuth-Plass:
estiramentPerEspai = ampladaNormalEspai × (maxWordSpacing - 1)
compressióPerEspai = ampladaNormalEspai × (1 - minWordSpacing)
Amb els valors per defecte (2 / 0.6), si l'amplada normal de l'espai és 4 px:
- Cada espai es pot estirar 4 px (de 4 px a 8 px)
- Cada espai es pot comprimir 1.6 px (de 4 px a 2.4 px)
Límits més estrictes (p. ex., maxWordSpacing: 1.2) produeixen un espaiat més uniforme però donen menys marge a l'algorisme, cosa que pot resultar en més partició de mots o, en casos extrems, desbordament. Límits més amplis (p. ex., maxWordSpacing: 2.5) donen més flexibilitat a l'algorisme però permeten un espaiat visiblement desigual en algunes línies.
Els valors per defecte de 2 i 0.6 prioritzen la flexibilitat de l'algorisme: donen a Knuth-Plass prou marge per evitar desbordaments, particions de mots i línies curtes en columnes estretes, mantenint-se dins del rang que la literatura tipogràfica considera acceptable.
#Línies que l'algorisme no pot omplir
Knuth-Plass no estira una línia més enllà de maxWordSpacing si té cap alternativa, i la correcció de les línies curtes finals tampoc (vegeu Penalitzacions d'òrfenes, vídues i línies curtes). Una línia que passa del límit costa més que qualsevol altre defecte que l'algorisme sospesa (un guionet, una última línia curta, una línia una mica més fluixa que les veïnes) des del moment que el supera, i el cost creix després amb el quadrat de la seva proporció d'estirament, de manera que l'algorisme prefereix partir una paraula, repartir l'excedent entre les línies del voltant o deixar dues línies una mica fluixes abans que una de massa fluixa.
A vegades cap conjunt de talls no respecta els límits. La línia que no admet la paraula següent té molt pocs espais entre els quals repartir l'excedent: la primera línia d'un paràgraf, amb el seu sagnat, seguida d'una paraula massa llarga per pujar i massa curta per partir-se; una línia de termes llargs que no es poden dividir; un URL llarg que només es talla per les seves juntures; un element de llista amb una última paraula que no puja, mentre que qualsevol partició per síl·labes deixaria una òrfena. La freqüència amb què passa depèn de la mesura, la font i la llengua. En una columna de 83 mm de text en anglès a 9,3 pt, entre el 2 % i el 8 % de les línies d'un capítol van superar maxWordSpacing segons la font (més com més ampla); el mateix capítol en castellà, una llengua amb una partició de mots que ofereix molts més talls, no en va tenir cap. Knuth-Plass accepta llavors la línia menys dolenta, i els seus espais superen el límit. Quan s'haurien d'estirar més de 3 vegades l'amplada normal de l'espai, el motor compon aquesta línia en bandera: es dibuixa amb el seu espaiat natural i cedeix el marge dret, com l'última línia d'un paràgraf. El llindar és el mateix que fa servir l'avís de línia fluixa del Sandbox. La línia es compon en bandera, i Postext en dona un avís: un avís de contingut raggedLine en porta el text, la pàgina i la proporció que hauria necessitat (al Sandbox, Línia justificada en bandera, entre els avisos de composició; si hi fas clic, se selecciona la línia), i VDTLine.raggedSpaceRatio desa aquesta proporció a la línia. Canvia la redacció o dona a la línia un punt on partir. Les línies dins del llindar es deixen tal com es van mesurar. El mateix val dins dels requadres, on la mesura estreta fa que passi més sovint; fins a postext 1.4 un requadre mantenia justificada aquesta línia per molt que s'estiressin els seus espais.
En columnes estretes sol ser la primera línia d'un paràgraf curt, que té pocs espais per culpa del sagnat, seguida d'un monosíl·lab o d'unes cometes d'obertura («„Beim Schwärmen stechen sie» + «nicht.»). El motor no treu el sagnat per salvar aquesta línia: un sagnat que canvia d'un paràgraf a l'altre es veu com un defecte al llarg de la columna, i una sola línia curta no. En columnes de revista de 60 i 92 mm en alemany, maxJustifyTracking: 12 (més avall) va baixar les línies de més de 2× del 8,8 % al 4,0 %; el que queda s'arregla al text.
Per tenir menys línies així, per aquest ordre: comprova que la partició de mots està activada i en la llengua del text; eixampla la mesura o redueix el cos; deixa que les línies prenguin una mica de tracking (secció següent); o puja maxWordSpacing, que fa que aquestes mateixes línies comptin com a dins del límit sense compondre-les d'una altra manera.
#Tracking com a últim recurs
bodyText.maxJustifyTracking deixa que una línia així prengui una mica de tracking —espaiat entre lletres— en lloc de més espai entre paraules, fins a aquest nombre de mil·lèsimes d'em per caràcter (10 = 0,01 em, la unitat d'InDesign). Funciona en tots dos sentits: una línia amb uns espais que s'estirarien més enllà de maxWordSpacing separa les lletres fins que els espais tornen al límit, i una línia que només hi cabria amb els espais per sota de minWordSpacing ajunta les lletres en lloc d'enviar una paraula a la línia següent. Knuth-Plass ho té en compte en triar els talls: una línia amb tracking costa una mica més que una dins dels límits i molt menys que una que els supera, de manera que el tracking només es pren on no n'hi ha prou amb l'espaiat entre paraules. Les línies dins dels límits, l'última línia d'un paràgraf (llevat que es desbordi), una línia d'una sola paraula i una línia amb un xip no el fan servir mai. La línia el desa com a VDTLine.letterSpacing, sumat al tracking del seu bloc, i canvas, HTML i PDF el pinten. Les paraules d'una escriptura lligada (àrab…) no porten mai tracking, ni aquest ni cap altre (el letterSpacing d'un estil, l'equilibratge de columnes, la correcció de les línies curtes finals): separar-ne les lletres trenca les unions. La línia no compta les seves lletres i les sortides les pinten sense tracking; un estil que defineix letterSpacing sobre aquest text genera l'avís joiningScriptLetterSpacing.
bodyText: {
  maxWordSpacing: 2,
  maxJustifyTracking: 10, // com a màxim 0,01 em per lletra, en un sentit o en l'altre
}
Està desactivat per defecte, de manera que els documents conserven les seves línies llevat que ho demanin. Al capítol en anglès d'abans, 10 ‰ va deixar les línies que superaven maxWordSpacing en una o cap per font, i 20 ‰ en cap en tres fonts de quatre. Mantén-lo baix: a partir d'uns 20 ‰ el tracking comença a notar-se com una línia més clara o més fosca.
#Caixida en el text àrab
Una línia àrab justificada no s'espaia entre lletres: les seves lletres s'enllacen, i separar-les trenca els enllaços. S'estira en dos llocs: els espais entre paraules i les caixides (kashida), els enllaços allargats que el cal·lígraf traça entre dues lletres unides (كتاب → كتـاب). Postext els insereix com a tatweels (U+0640, ـ), sencers, que la font dibuixa com un sol traç; l'Amiri converteix una sèrie d'un a set en una caixida corba.
bodyText.kashida val 'auto' per defecte en un document en una llengua que s'escriu amb alfabet àrab (ar, fa, ur…) i 'none' en qualsevol altre; posa-hi 'auto' per allargar les paraules àrabs citades en un llibre d'una altra llengua. Cada línia, tret de l'última del paràgraf, obre primer els espais fins a una quarta part de la seva amplada i després afegeix caixides per a la resta del sobrant, d'un tatweel en un tatweel, primer als millors llocs i en voltes successives, i torna a mesurar cada paraula sencera amb els tatweels; el que sobra, menys d'un tatweel, torna als espais. Knuth-Plass compta l'allargament possible de cada paraula com a estirament, de manera que tria els talls sabent que una línia de paraules àrabs s'hi pot eixamplar.
On pot anar una caixida surt de les regles de raqim-kashida (MIT): només entre dues lletres que s'enllacen, mai després d'una lletra que no enllaça amb la següent (ا د ذ ر ز و ة), mai al final de la paraula, mai dins del lām-alif, i sempre després dels signes de la lletra anterior. kashidaPatterns: 'naskh' segueix les regles clàssiques del naskh (la matriu de Benatia amb les prohibicions d'Afifi: res després de kāf o lām, res abans de ṣād, ʿayn o wāw, un hāʾ pronominal final s'allarga just abans); 'simple', les prioritats de Microsoft per a tipus moderns senzills; 'nastaliq', les regles del naskh adaptades al nastaʿlīq. El valor per defecte, 'auto', mira la font del text: cap caixida en un tipus ruqʿa o dīwānī com l'Aref Ruqaa, regles de nastaʿlīq en un tipus nastaʿlīq, naskh en els altres. Una paraula pren com a màxim kashidaPerWord allargaments (1 per defecte) de kashidaMaxLength em com a molt (0,6, tres tatweels de l'Amiri). Una paraula amb un tatweel escrit per l'autor s'allarga allà. Les paraules llatines, les xifres, els títols, les línies en bandera i l'última línia d'un paràgraf no en prenen mai cap.
bodyText: {
  kashida: 'auto',          // el normal en un llibre àrab
  kashidaPatterns: 'naskh', // 'auto' el tria per la font
  kashidaMaxLength: 0.6,    // em
}
Els tatweels formen part del text pintat (cada segment els llista a VDTLineSegment.kashida i la línia els compta a VDTLine.kashida); el text sense format, el mapa del text font, els enllaços i el text copiat del PDF els deixen fora.
#L'última línia
En el model caixa-cola-penalització, cada paràgraf acaba amb una cola d'amplada 0 i infinitament estirable seguida d'un tall forçat. Aquesta cola final absorbeix a cost zero tot l'espai que quedi a l'última línia, de manera que les últimes línies surten irregulars de manera natural: es renderitzen a la seva amplada natural, i el justifiedSpaceRatio només es calcula per a les línies que no són finals.
Hi ha una excepció. Knuth-Plass pot acceptar una línia final amb un contingut natural més ample que la mesura, si compta que la cola entre paraules es comprimirà: és la semàntica estàndard d'ajust de la cola (glue-setting) de TeX. Els tres backends detecten aquest cas (l'amplada natural del contingut de la línia supera la mesura efectiva) i comprimeixen els espais entre paraules d'aquesta última línia perquè encaixi exactament en la mesura en lloc de desbordar-la. La comprovació s'aplica de manera idèntica als backends de canvas, PDF i HTML.
#Tall òptim vs. voraç
La propietat bodyText.optimalLineBreaking (per defecte: true) controla quin algorisme de tall de línies fa servir el motor:
true: algorisme de programació dinàmica de Knuth-Plass. Avalua tots els conjunts de talls possibles i tria el globalment òptim. És la configuració recomanada per a qualsevol text justificat. El text corregut en bandera també el fa servir ambbodyText.optimalRagged(activat per defecte): els espais entre paraules no canvien d'amplada i l'algorisme pondera en canvi quant es queda curta cada línia respecte de la mesura, de manera que una línia 3 em més curta costa el mateix que una línia justificada ambmaxWordSpacing; així el marge irregular queda més igualat i s'apliquen les regles contra les línies curtes.false: algorisme voraç de primer ajust, amblayoutNextLine()de Pretext. Més ràpid, però amb resultats de menys qualitat. Fes-lo servir només quan el rendiment importa més que la qualitat tipogràfica (p. ex., previsualització en temps real amb recomptes de caràcters molt alts).
Quan Knuth-Plass està actiu i no produeix talls vàlids (cosa que pot passar amb columnes extremadament estretes o paraules més llargues que l'amplada de columna), el motor recorre automàticament al tall voraç per a aquest paràgraf.
#Línies amb tabulador
Un paràgraf amb un tabulador (vegeu Format del document › Tabuladors i tabulacions) es compon línia a línia, com componen el text tabulat els processadors de text i InDesign, mai amb Knuth-Plass, digui el que digui optimalLineBreaking. On cau un tabulador depèn de fins on ha arribat la seva línia, i la cerca òptima suma les amplades de cada línia candidata com si no en depengués. El mateix val per al text xinès i japonès: un paràgraf amb un tabulador es talla entre caràcters segons les regles de tall de línia del document, sense compressió de la puntuació ni justificació entre caràcters.
En un paràgraf justificat, una línia amb un tabulador no s'estira abans del seu últim tabulador, perquè les tabulacions fixen on comença cada part de la línia. Només els espais entre paraules que segueixen l'últim tabulador absorbeixen el sobrant, i només quan la línia no és l'última del paràgraf; una línia sense cap espai entre paraules després del seu últim tabulador es compon tal com queda. Les línies en bandera no hi tenen res a veure. La línia registra que porta un tabulador (VDTLine.tabbed); cada tabulador és un segment d'espai que porta la seva tabulació (VDTLineSegment.tab), i cada farciment un segment propi (VDTLineSegment.leader, 'text' o 'rule').
L'equilibratge de columnes no recompon mai un paràgraf així amb una línia més ni hi aplica tracking: es queda tal com s'ha mesurat, de manera que les seves tabulacions no es mouen.
#Xinès, japonès i coreà
Un paràgraf amb més caràcters CJK que espais entre paraules el compon el compositor CJK, no Knuth-Plass. Cada buit entre dos caràcters és un lloc on la línia es pot tallar (llevat d'on ho impedeixen les regles de cjk.lineBreak), de manera que una cerca òptima no té res a sospesar; les línies s'omplen una darrere l'altra. Quan un caràcter no hi cap, la línia intenta primer admetre'l cedint blanc de la puntuació i dels espais (push-in: els espais entre paraules fins a un quart de quadratí, després els punts volats, els parèntesis, els signes de pausa, els espais entre xinès i llatí fins a un vuitè de quadratí i els signes de final d'oració, segons ho permeti cjk.punctuationWidth); només si no n'hi ha prou, un caràcter que no pot obrir línia s'emporta l'anterior. Les regles s'expliquen a Tipografia d'Àsia oriental. Composició xinesa tracta la resta de la composició xinesa: l'amplada de la puntuació segons la regió, la retícula de caràcters i el text vertical. Un document japonès segueix en canvi JLReq (vegeu Composició japonesa): els seus nivells de kinsoku, una línia que retorna espai en l'ordre de JLReq §3.8.3 (primer el mig quadratí després del signe que acaba la línia, sencer o res, i mai el blanc després de 。 dins de la línia), i cap espai afegit després d'un parèntesi d'obertura, davant d'un de tancament o al costat de 、。・:;?! quan la línia s'espaia.
Una línia justificada d'un paràgraf així, llevat de l'última, s'eixampla fins a la mesura en l'ordre que fixa clreq (§6.2.2.4):
- Els espais entre paraules occidentals, per igual, fins a mig quadratí cadascun.
- Els espais entre xinès i llatí (
cjk.latinSpacing), per igual, fins a mig quadratí cadascun. - Tots els buits entre caràcters, per igual, també els espais entre xinès i llatí: entre caràcters han, entre un han i un signe de puntuació, entre un han i una paraula llatina. Mai dins d'una paraula llatina, d'un nombre o d'una ratlla o uns punts suspensius de dos quadratins, i mai al costat d'un connector (~, –, una ratlla — sola) o una barra. Un signe penjat fora del final de la línia (
cjk.hangingPunctuation) queda fora de la mesura.
L'última línia d'un paràgraf es compon sense eixamplar. L'espaiat es desa per segment de la línia (VDTLineSegment.tracking), de manera que el canvas, l'HTML i el PDF pinten les mateixes posicions, i el Sandbox col·loca el cursor al caràcter on has fet clic.
Una línia que necessitaria més de mig quadratí entre els seus caràcters —o més que bodyText.maxJustifyTracking, si està definit— es compon amb aquest màxim, més curta que la mesura, i genera un avís de contingut cjkLooseLine (al Sandbox, Línia CJK curta). Sol passar per una paraula llatina llarga o per una adreça web que no hi va poder pujar. Una línia sense cap caràcter CJK, com el començament d'una adreça web llarga, queda en bandera sense l'avís.
Per al ressaltat de línies fluixes, una línia CJK és fluixa segons el seu espaiat: la seva proporció és 1 més el seu espaiat en vuitens de quadratí, de manera que, amb el llindar per defecte de 3, es marca una línia amb caràcters separats més d'un quart de quadratí (lineLooseness(line, fontSizePx) dona la proporció). L'equilibratge de columnes pot allargar una línia un paràgraf CJK: talla les línies una mica abans de la mesura, un vuitè de quadratí cada vegada fins a dos quadratins, i les torna a eixamplar fins a ella. En una retícula de caràcters només pot separar dos caràcters fins a headings.balancing.maxTracking, perquè els caràcters conservin les seves caselles (vegeu Justificació vertical: equilibratge de columnes).
#Depuració de línies fluixes
Fins i tot amb Knuth-Plass i amb partició de mots, algunes línies seran més fluixes del que seria ideal, sobretot en columnes estretes amb paraules llargues, o en llengües amb poques oportunitats de partició de mots. La funció de depuració ressaltat de línies fluixes t'ajuda a trobar aquestes línies problemàtiques a l'instant.
#Com funciona
Cada línia justificada de l'arbre de document virtual porta un justifiedSpaceRatio: l'amplada a què es pinten els seus espais dividida per l'espai de la rodona. Un valor d'1.0 és l'espai de la rodona; 2.5, espais 2.5 vegades més amples. Una línia amb espais d'un altre estil (una frase en cursiva, una paraula en negreta) porta un segon nombre, justifiedSpaceLimitRatio, el seu espaiat entre paraules tal com el fiten minWordSpacing i maxWordSpacing. lineWordSpacing(line) dona el nombre que cal comparar amb els límits: el segon quan la línia en té, i si no el primer.
Quan debug.looseLineHighlight.enabled és true, el Sandbox pinta sobre la seva vista Canvas una capa semitransparent a cada línia amb un espaiat entre paraules (lineWordSpacing) que supera el threshold configurat. Una línia composta just a maxWordSpacing que conté un espai en negreta es pinta unes centèsimes d'espai més enllà i no es compta: l'algorisme de tall de línies ha respectat el límit. El llindar per defecte és 3, és a dir, només es ressalten les línies amb espais tres vegades més amples del normal. És un llistó deliberadament alt; les línies tan fluixes són problemes tipogràfics reals. És també l'amplada a partir de la qual el motor compon en bandera una línia justificada en lloc d'estirar-la (vegeu Línies que l'algorisme no pot omplir), de manera que, amb el valor per defecte, el ressaltat i l'avís looseLines gairebé no troben res en el text corregut: aquesta línia es compon en bandera i genera l'avís raggedLine. Baixa el llindar a 1,5 o 2 per trobar les línies fluixes que continuen justificades.
La capa no forma part de la pàgina, de manera que les pàgines exportades no la mostren mai. Per dibuixar-la en un canvas propi, crida drawLooseLines(ctx, page, doc, { threshold }) just després de renderPageToCanvas; findLooseLines(doc, { threshold }) retorna aquestes mateixes línies com a dades (consulta Línies fluixes al teu propi canvas).
#Configuració
El ressaltat de línies fluixes forma part de la secció debug de PostextConfig:
| Propietat | Tipus | Per defecte | Descripció |
|---|---|---|---|
looseLineHighlight. | boolean | false | Si es ressalten les línies fluixes. |
looseLineHighlight.color | ColorValue | #ff000040 | Color de la capa de ressaltat. El valor per defecte és un vermell semitransparent. |
looseLineHighlight. | number | 3 | Multiplicador de l'amplada normal de l'espai per sobre del qual una línia es considera fluixa. Valors més baixos en capturen més; valors més alts ressalten només les pitjors. A partir de 3 el text corregut gairebé no en mostra cap, perquè les línies que passen de 3 vegades es componen en bandera. |
debug: {
  looseLineHighlight: {
    enabled: true,
    threshold: 2.5,
    color: { hex: '#ff660040', model: 'hex' },
  },
}#Interpretar els resultats
Quan actives el ressaltat de línies fluixes i veus bandes vermelles en certes línies, vol dir que el motor no ha pogut trobar una manera de compondre aquestes línies sense un espaiat excessiu. Comença per dalt: les causes estan ordenades de més probable a menys.
| Causa | Solució |
|---|---|
| La columna és massa estreta per a la mida de font | Augmenta l'amplada de columna, redueix la mida de font o canvia a una composició d'una sola columna. |
| Paraules llargues amb pocs punts de partició | Verifica que la partició de mots estigui activada i que la llengua correcta estigui configurada. Alguns termes tècnics o noms propis no tenen punts de tall vàlids. |
| La partició de mots està desactivada | Activa bodyText.. La justificació sense partició de mots és gairebé sempre pitjor. |
| Unes poques línies continuen fluixes amb qualsevol font | Deixa que aquestes línies prenguin una mica de tracking: bodyText.. Vegeu Tracking com a últim recurs. |
| Els límits d'espaiat són massa estrictes | Augmenta maxWordSpacing lleugerament (p. ex., de 2 a 2.4). Això dona més espai a l'algorisme. |
| La llengua té paraules compostes llargues (p. ex., l'alemany) | Assegura't que la llengua correcta estigui configurada. Els patrons de partició de mots de l'alemany gestionen bé les paraules compostes, però només si el motor sap que és alemany. |
#Justificació vertical: equilibratge de columnes
Knuth-Plass resol el problema horitzontal: on es talla cada línia. L'equilibratge de columnes resol l'equivalent vertical: on acaba cada columna. Les editorials esperen que totes les columnes d'una pàgina comencin a dalt i acabin arran del peu, línia a línia, a tota la doble pàgina. Les mateixes regles que protegeixen la qualitat del text hi juguen en contra: la protecció d'òrfenes i vídues, els encapçalaments amb keepWithNext i les figures indivisibles empenyen contingut a la columna següent abans que l'actual estigui completament plena, i deixen una o més línies de la retícula de base buides a la part inferior.
Amb headings.balancing activat (el valor per defecte, tret del text vertical i d'una retícula de caràcters), el motor tanca aquests buits com ho faria un maquetista, i aplica les palanques en un ordre estricte de prioritat editorial; cada palanca només actua sobre el que l'anterior no ha pogut absorbir:
-
Un requadre que tanca la columna. Un requadre que acaba una columna curta baixa exactament l'espai que queda sota el seu peu, de manera que la seva vora inferior cau a l'última línia de la retícula, a nivell amb la columna contigua; aquest espai pot ser una fracció de línia. Actua primer i es queda tot el buit llevat que
closingBoxdigui una altra cosa:'last'deixa que les palanques de sota prenguin abans les línies senceres i dona al requadre només el que deixen, de manera que un requadre que comenta el paràgraf de sobre queda a prop seu;'off'no mou mai el requadre. -
Imatges amb zona segura. Una imatge amb un recurs que marca una zona segura (
Resource.safeArea, la part que sempre s'ha de veure; vegeu Format del document › Zona segura) creix en línies senceres de retícula quan és en línia a la columna curta, o quan flota al capdamunt o al peu d'aquesta columna i només sobre aquesta: el motor retalla el que queda fora de la zona segura per fer-la més alta, a tota l'amplada. Una imatge més alta no deixa cap forat a la pàgina, així que va abans d'afegir cap espai. Un flotant que encapçala una columna en una pàgina o banda de tancament, on els caps de columna queden anivellats, no creix. -
Espai sobre els encapçalaments. S'afegeixen línies completes de retícula al marge superior dels encapçalaments de la columna curta. Quan calen diverses línies i la columna conté diversos encapçalaments, les línies es reparteixen en rondes per ordre d'importància, de manera que l'encapçalament més important rep sempre la part més gran: 3 línies per a un
h2i unh3es converteixen en +2 sobre l'h2i +1 sobre l'h3. Els encapçalaments situats al principi d'una columna no reben mai espai addicional (les columnes continuen començant a dalt), i un encapçalament final no s'empeny mai cap al peu de la columna. Un encapçalament pren així com a màximmaxLinesBeforeLooselínies (dues per defecte) abans de provar les palanques següents, i les altres, fins amaxLinesPerHeading, només quan aquestes ja no poden donar més. -
Espai després del final de les llistes. S'afegeix una línia de retícula on acaba una llista o enumeració: l'aire després d'una llista es llegeix amb naturalitat. Amb un màxim per llista (
maxLinesAfterList, per defecte 1). Després, una línia de retícula sota una fórmula en bloc o un requadre seguits de text (stretchAfterDisplays), i una altra sota una figura o taula que encapçala la columna (stretchAfterFloats,maxLinesAfterFloat). El text sota la figura pot ser la continuació d'un paràgraf començat a la pàgina anterior; baixa igualment, tanta distància com la línia que les regles de tall han deixat lliure al peu de la columna (una línia que la regla de les vídues ha deixat buida, un espai entre paràgrafs sense lloc per a text a continuació). Sota una figura a diverses columnes, la línia només s'afegeix quan la prenen totes les columnes que queden sota la figura, de manera que els caps continuen a la mateixa altura, o quan deixa la columna arran del peu (stretchAfterWideFloats). -
Paràgrafs fluixos. Com a últim recurs, es recomponen paràgrafs de la columna amb una línia més (el
\looseness=+1de TeX), fins a un màxim demaxLooseParagraphs(dos per defecte), una línia extra cadascun. L'algorisme torna a executar Knuth-Plass demanant exactament una línia addicional i només accepta el resultat quan totes les línies de la nova composició queden per sota demaxWordSpacing: el color tipogràfic no supera mai el límit que ja tinguis configurat. El motor prefereix els paràgrafs més llargs de la columna, on l'espai extra es dilueix entre més espais i resulta invisible. RequereixoptimalLineBreaking(el valor per defecte); els paràgrafs partits entre columnes en queden exclosos. Un paràgraf que la correcció de les línies curtes finals (tightenRunts) ha compost amb una línia menys compta la línia de més a partir d'aquella composició: pot recuperar la línia que li ha tret la correcció, però només amb una composició sense línia curta i sense cap línia per sobre demaxWordSpacing(fins a postext 1.4 podia tornar amb una línia molt per sobre del límit).Quan l'espaiat entre paraules no basta per guanyar la línia, el paràgraf també pot fer servir una mica de tracking positiu, el recurs clàssic del caixista. El motor prova primer la quantitat més petita (la meitat de
maxTrackingi desprésmaxTracking, en mil·lèsimes d'em per caràcter; 10 = 0,01 em per defecte) i es queda la primera que guanya la línia, sempre sota el mateix límit d'espaiat entre paraules. El tracking es mesura a les línies del paràgraf i el pinten tots els backends (letterSpacingen canvas,letter-spacingen CSS, espaiat de caràcters en PDF). Es desactiva ambtrackParagraphs: false.
#Per què l'ajust és local
Els salts de columna estan lligats a elements: l'element que obre la columna següent hi és perquè no cabia al buit. Empènyer cap avall la part final d'una columna, com a màxim tant com el seu buit, no mou mai contingut a la columna o la pàgina següent: cada columna es corregeix al seu lloc, sense recomposicions en cascada. Tot i així, el motor ho verifica empíricament: torna a executar la col·locació amb els ajustos proposats (fins a 8 passades), mesura el buit restant total i conserva sempre la millor maquetació trobada. Un paràgraf fluix que no aconsegueix guanyar la línia dins del límit d'espaiat, amb cap tracking, es descarta i es prova el candidat següent.
#Quan es respecta una columna curta
De vegades, una columna curta és el resultat correcte, i l'equilibratge sap quan no ha d'actuar:
- L'última columna d'una pàgina només s'equilibra quan la pàgina flueix de manera natural cap a la següent. Les pàgines acabades amb
:::pagebreak, amb elbreakBefored'un encapçalament o amb un inici de capítol conserven curta l'última columna: és normal que un capítol acabi a mitja pàgina. - L'última pàgina del document no s'equilibra mai.
- Una columna sense cap punt elàstic utilitzable (sense encapçalament elegible, final de llista ni paràgraf recomponible) conserva el seu buit abans que degradar la tipografia.
- Un paràgraf amb un tabulador no es recompon mai més fluix ni s'hi aplica tracking (vegeu Línies amb tabulador).
const doc = buildDocument(content, {
  headings: {
    balancing: {
      enabled: true,            // per defecte
      maxLinesPerHeading: 4,    // màxim per encapçalament
      maxLinesBeforeLoose: 2,   // línies abans de les altres palanques
      stretchAfterLists: true,  // palanca 4
      maxLinesAfterList: 1,     // màxim per final de llista
      stretchAfterDisplays: true, // sota una fórmula o un requadre
      looseParagraphs: true,    // palanca 5 — limitada per bodyText.maxWordSpacing
      maxLooseParagraphs: 2,    // paràgrafs folgats per columna curta
      trackParagraphs: true,    // permet una mica de tracking en un paràgraf folgat
      maxTracking: 10,          // ‰ d'em per caràcter (0,01 em)
      closingBox: 'first',      // palanca 1: 'first' | 'last' | 'off'
    },
  },
});
Al Sandbox, aquestes opcions són a la secció Títols de Disseny → Títols i índex («Equilibrar columnes», amb «Estirar després de llistes», «Estirar sota figures», «Requadre que tanca una columna» i «Paràgrafs fluixos» a sota). Activa la retícula de base (Disseny → Avançat → Ajudes en pantalla) i mira la pestanya Canvas per veure'n l'efecte: amb l'equilibratge desactivat, les columnes curtes acaben per sobre de l'última línia de la retícula; amb l'equilibratge activat, totes les columnes equilibrables tanquen a la mateixa línia. Consulta la pàgina de Configuració per a la referència completa d'opcions.
#Exemple complet
Una configuració completa que mostra tots els paràmetres de partició de mots i justificació:
import { buildDocument } from 'postext';

const vdt = buildDocument(content, {
  bodyText: {
    fontFamily: 'EB Garamond',
    fontSize: { value: 9, unit: 'pt' },
    textAlign: 'justify',

    // Tall òptim de línies Knuth-Plass (per defecte: true)
    optimalLineBreaking: true,

    // Partició de mots
    hyphenation: {
      enabled: true,
      locale: 'es',
    },

    // Límits d'espaiat entre paraules (multiplicadors de l'amplada normal)
    maxWordSpacing: 2,     // els espais s'estiren fins al 200%
    minWordSpacing: 0.6,   // els espais es comprimeixen fins al 60%
  },

  // Depuració: ressaltar línies amb espaiat excessiu
  debug: {
    looseLineHighlight: {
      enabled: true,
      threshold: 2.5,
      color: { hex: '#ff000040', model: 'hex' },
    },
  },
});
Per a la llista completa d'opcions del text de cos, consulta la pàgina de Configuració. Per veure com fa servir aquests paràmetres el procés de composició durant la mesura del text, consulta la pàgina d'Arquitectura.
#Exemples al Receptari
Receptes que fan servir el que explica aquesta pàgina, cadascuna sota la secció a què respon millor. Cada recepta mostra les seves pàgines al costat de l’script complet.
Knuth-Plass: veure el paràgraf sencer
- Núm. 016Castellà justificat en una novel·la de butxaca
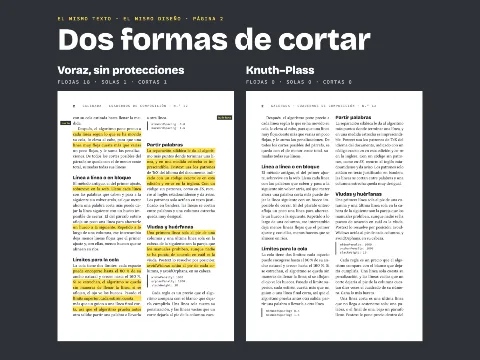
- Núm. 184Prosa justificada sense repeticions als extrems de línia
- Núm. 186Cites i estadístics fora de les vores de línia
- Núm. 014Espaiat uniforme en columnes estretes i justificades
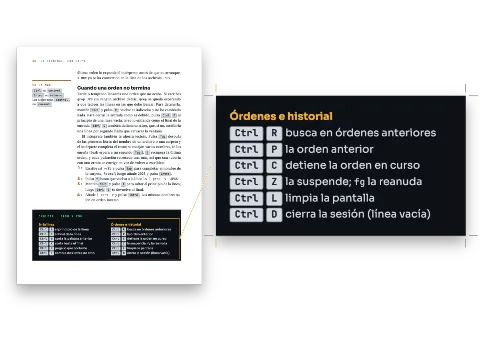
- Núm. 048Llistats de codi i tecles
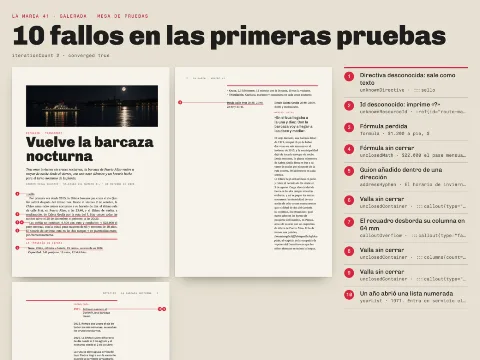
- Núm. 055Una galerada amb cada error marcat en vermell
3 receptes més amb Tall de línies òptim (Knuth–Plass) al Receptari
Llengües compatibles
- Núm. 130Japonès en lletres llatines: el diari en rōmaji de Takuboku
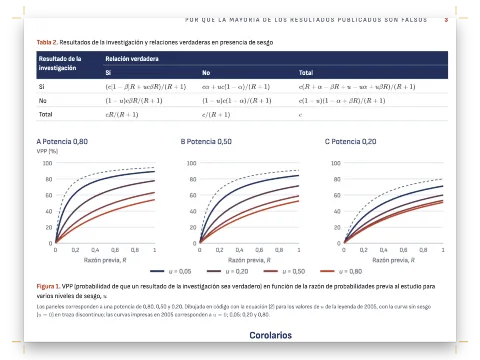
- Núm. 141Un assaig de metaciència en anglès i en castellà
- Núm. 104Una novel·la curta en català, amb la partició de l'IEC
- Núm. 064Edició de cartes: dates i signatures
- Núm. 068Assaig fotogràfic amb làmines a sang
- Núm. 043Traducció acarada, estrofa a estrofa
15 receptes més amb Partició de mots i llengua del document al Receptari