章 4 · 篇 II · 工艺
断词与两端对齐
Postext怎样用Knuth-Plass算法断行、把文字排成两端对齐并控制词间距
简单来说
本页说明Postext怎样把词语分布在每一行上。段落两边都对齐时,词与词之间的空隙可能拉得太大,很难看。Postext先看完整个段落,再决定每一行在哪里结束,所以空隙能保持均匀。它还能在正确的位置用连字符拆开长单词。你可以设定空隙最多能拉多大,并把仍然显得松散的行标出来。本页还介绍Postext怎样让各栏在同一高度结束。
业余排版和专业排版的差别,就在词与词之间的空隙里。
随手翻开一本平装小说。正文两端对齐,每段的左右两边都整整齐齐。再凑近看:一行接一行,词间距几乎一致。页面上没有一道道纵贯而下的白色“河流”,也没有哪一行只剩两个词,中间隔着一大片空白。做到这一点远比看上去难,排版技术在这一个问题上花的工夫比在其他任何问题上都多。
Postext用的是TeX自1981年起一直使用的算法:Knuth-Plass最优断行。再加上TeX品质的断词模式、可配置的词间距上下限,以及一套用来找出问题行的可视化调试手段,引擎排出的两端对齐文本能够达到出版标准。
#问题所在
文本以textAlign: 'justify'排版时,除末行外,每一行都要拉伸或压缩到恰好等于栏宽。引擎把内容自然宽度与栏宽之差分摊到该行的各个词间空格上。(末行按自然宽度排,右边不齐;唯一的例外见末行。)
一行里词多,每个空格只需要微调一点,读者察觉不到。一行里词少(比如一个长词迫使提前断行),每个空格就得大幅拉伸,结果是松散行:词间距宽得打乱阅读节奏,留下难看的空隙。
反过来也有问题。如果引擎在一行里塞进太多词,空格就会缩到自然宽度以下,形成词挤在一起的紧缩行。
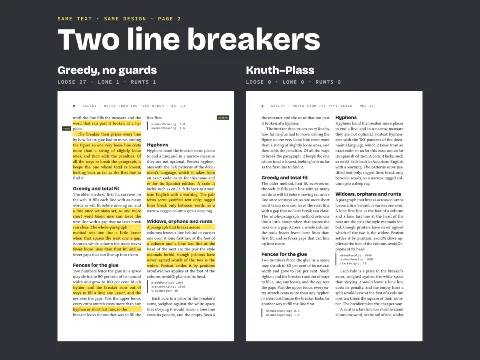
朴素的断行算法(CSS用的就是这种)一次只决定一行:在当前行里尽量多放词,断开,接着排下一行。这种贪心的首次适配方法有一个根本缺陷:它看不到后面。对第5行看似最优的决定,可能逼得第6行只能在很糟的地方断开。等算法排到第6行,已经来不及了,第5行早已定下。
#Knuth-Plass:通观整个段落
Knuth-Plass算法由Donald Knuth和Michael Plass于1981年发表,思路完全不同。它不是一次断一行,而是考虑整个段落所有可能的断行方式,选出使各行“劣度”总和最小的组合。TeX用的正是这个算法;四十多年来,TeX排出的文档一直是两端对齐文本的黄金标准,原因就在这里。
#盒子–粘连–惩罚值模型
Knuth-Plass不按词和空格来看待文本,而是把文本看作由三种基本元素组成的序列:
| 基本元素 | 代表 | 行为 |
|---|---|---|
| 盒子(Box) | 一个词或文本片段 | 宽度固定。不能拉伸或压缩,也不能断开。 |
| 粘连(Glue) | 词间空格 | 有自然宽度、伸展量和收缩量。引擎可以在这些范围内调整粘连来填满一行。 |
| 惩罚值(Penalty) | 一个可能的断点 | 有一个代价。惩罚值低,断开的代价小;惩罚值高,代价大。带标记的惩罚值表示断词位置(选用时会画出一个连字符)。 |
一个段落会变成这样的序列:
[box "The"] [glue] [box "quick"] [glue] [box "brown"] [glue] [box "fox"]
[penalty -∞]  ← forced break at paragraph end
启用断词后,长词会被拆成片段,片段之间用惩罚值隔开:
[box "ty"] [penalty 50, flagged] [box "pog"] [penalty 50, flagged] [box "raphy"]
每个带标记的惩罚值代价为50:不是免费的,但比排出一个松散行便宜。
#如何找到最优解
算法采用动态规划。它维护一组活动节点,即可以开始新一行的潜在断点,并从每个活动节点出发评估所有可行的断点。对每个候选断点,它计算:
-
伸缩比(r):这一行的粘连需要伸展或收缩多少。
r = 0表示这一行刚好排满;r > 0表示需要伸展(松);r < 0表示需要收缩(紧)。 -
劣度:衡量间距不均匀的程度,计算公式为
100 × |r|³。立方增长意味着稍松的行可以容忍,很松的行则会受到重罚。r = 2的行劣度为800;r = 0.5的行劣度为12。 -
适配等级:每一行归入紧(
r < -0.5)、正常(-0.5 ≤ r < 0.5)、松(0.5 ≤ r < 1.0)或很松(r ≥ 1.0)四类之一。紧行紧挨着很松的行,反差会很刺眼,所以相邻两行的等级相差超过一级时要受罚。 -
缺陷值:在此处断行的总代价。与TeX一样,劣度与断点惩罚值以平方公式组合:惩罚值非负时
demerits = (1 + badness + penalty)²;惩罚值为负(表示希望在此断开)时则减去它的平方:(1 + badness)² − penalty²。在此之上再加两项固定缺陷值:- 连续连字符缺陷值(默认3000):惩罚连续两行都以断词结尾,因为叠在一起的连字符会分散注意力。
- 适配等级缺陷值(默认100):本行适配等级与上一行相差超过一级时加上。
下文介绍的孤字惩罚值也进入这个公式,以额外劣度的形式注入;段首孤行和段末孤行惩罚值则在更晚的阶段起作用,即段落跨栏拆分时。
算法在整个段落范围内选出缺陷值总和最低的断点序列;它胜过贪心算法的地方,全在于此。
算法沿着活动节点回溯,找出缺陷值总和最低的路径,也就是整个段落全局最优的一组断点。
段首孤行、段末孤行和孤字惩罚值
Postext在标准代价模型之上加了三项书刊排版上的惩罚值,引导引擎避开段落结尾和栏底难看的版面:
- 段末孤行(orphan)惩罚值:候选拆分会在下一栏顶部留下少于
orphanMinLines行时生效。orphanPenalty默认为1000。 - 段首孤行(widow)惩罚值:拆分会在当前栏底部留下少于
widowMinLines行时生效。widowPenalty默认为1000。 - 孤字惩罚值:段落末行短于约
runtMinCharacters × normalSpaceWidth像素时生效。这里数的是词间空格宽度的个数,而不是字母数:默认值20大约相当于8到12个字母长的末行。runtPenalty默认为1000,对所有孤字都一样;启用gradedRuntPenalty后,它按该行的欠缺程度缩放,即runtPenalty × (1 − width / threshold),于是末行有两个词比只有一个词代价低;如果上面某行能让出一个词,前者就会胜出。段首孤行和段末孤行惩罚值是线性加到拆分缺陷值上的;孤字惩罚值则不同,它在Knuth–Plass平方公式内部以等效劣度注入,这样它与行劣度(上限为10000)在同一尺度上竞争,而不会被后者淹没。
如果惩罚值仍然没能避免孤字(其他断法全都不可行),引擎就采用排字工人手工处理的办法:把段落排短一行(tightenRunts)。每一行的词间距都收紧,但不低于minWordSpacing;仅靠这一点还容不下落单的词时,再加一点负字距,取可行的最小一步,且不超过maxRuntTracking(单位为千分之一em)。排短后的版面同样要遵守maxWordSpacing。把这些词挤进少一行,多数行会收紧,但也可能挪动某个断点,使另一行不得不大幅拉伸。如果某种排法会让一行拉伸超过maxWordSpacing,或者在段落里已有更松的一行时超过那一行,那就不算修正,孤字保留。只有仍保持两端对齐的行才计入:因为拉伸会超过正常空格3倍而被段落改排为齐左的行(见断行算法填不满的行)不会放宽这个上限,而且排短后的版面中齐左的行不得多于原段落。这项修正也不会用超过上限的两端对齐行去换掉一行齐左的行:这时段落保留它的齐左行和孤字。各栏齐底反过来遵循同样的规则:为填满一个偏短的栏而要把某个段落多排一行时,如果多出的那一行以孤字结尾,就不动这个段落。填满一栏不是让一个音节落单的理由。
用这种办法排短的块会注明这一点:VDTBlock.runtFix的值为{ tracking },即所用的负字距,单位是千分之一em;只靠词间空格就排下时为0。渲染器不读它;它是给调整文稿长度的人用的:字距收到上限的段落,在相邻段落旁边显得紧,删去几个词本来就能不收字距排下。
孤字惩罚值在断行算法内部加到候选节点的缺陷值上,所以求解器可以用稍松的一行去换一个更长的末行,但只限于maxWordSpacing之内:拉伸超过这个上限的行会带上一份比任何孤字或连字符惩罚值都大的额外劣度,因此断行算法宁可接受较短的末行或断开的末词,也不让词间距越过上限。段首孤行和段末孤行惩罚值进入另一项优化,它在段落跨越栏边界时运行:对每个候选拆分打分(空余量、段首孤行和段末孤行缺陷值相加),代价最低的拆分胜出,因此只要可能,引擎自然会选择两种孤行都避开的拆分。调整orphanPenalty、widowPenalty或runtPenalty可以改变其间的取舍;把其中任何一个设为0即可完全关闭该规则,也可以用avoidOrphans、avoidWidows或avoidRunts(默认都为true)整条关闭。列表项通过avoidOrphansInLists、avoidWidowsInLists和avoidRuntsInLists启用这些规则(默认都为true)。这些规则让同一列表项的各行保持在一起;shortListSplit则让短列表的各项保持在一起(默认关闭,见正文)。
#为什么重要
实际差别肉眼可见。在贪心排出的版面里,你会发现某些段落有一行明显比相邻的行松;仔细看就会发现,原因是上一行多拿了一个词。Knuth-Plass能看到后果,所以会让当前行稍差一点,换来下一行好得多,从而避免这种情况。
#Postext的实现
Postext在核心包的knuthPlass/模块中完整实现了Knuth-Plass算法:一个动态规划核心(活动节点、缺陷值、回溯),加上两条转换路径,负责把文本转换为盒子–粘连–惩罚值模型:
- 纯文本路径:用
@chenglou/pretext做不依赖DOM的文本测量。Pretext提供片段宽度和软连字符宽度,Postext把它们转换成KP元素。 - 富文本路径:用基于Canvas的测量处理粗体和斜体片段。每个带样式的记号变成一个或多个盒子,断词位置作为惩罚值插入。
动态规划核心有两份实现,两者选出的断点完全相同:一份是TypeScript,另一份自postext 1.33起用Rust编写并编译为WebAssembly,默认由它作答,速度更快。模块编译完成之前,以及WebAssembly不可用的地方,由TypeScript断行器作答,所以段落由哪一份排出永远不会改变版面(见断行器(WebAssembly))。
两条路径都会为每一行计算justifiedSpaceRatio:该行每个空格绘制的宽度除以正体的空格宽度。一行里的空格都绘制得一样宽,不管它来自正体、斜体还是粗体。上下限约束的却是一个略有不同的量:每个空格相对于自身宽度的变化,以正体空格为单位计算;而斜体或粗体的空格比正体的窄一些或宽一些。所以含有这种空格的行,虽然断行时守住了上下限,绘制出来却略低于minWordSpacing或略高于maxWordSpacing;这样的行还带有justifiedSpaceLimitRatio,即上下限所约束的那个数:1加上该行的空余量除以它的各个空格(各按自身宽度计)。lineWordSpacing(line)返回这个数;如果一行的空格全是正体,两者是同一个数,它就返回justifiedSpaceRatio。这个值供下文介绍的松散行调试功能使用;排版本身(改排齐左、孤字修正、放松段落这一手段)仍然读取绘制的比值。这些比值只对非末行计算;末行怎样排见末行。
断行算法之外,文本测量位于measure/模块:纯文本和富文本测量路径、Canvas字形度量、字体字符串处理,外面包着一层显式的测量缓存。某个字体族的字体加载进来或被移除时,引擎丢弃它在该字体族中测得的结果,包括它的宽度缓存和宿主持有的测量缓存中的内容,所以网络字体加载完成后测量结果依然准确,宿主无须清除任何缓存(见排版前加载字体)。解析,即把源文本变成块和行内片段的阶段,位于parse/模块。这些模块的文件级结构见架构页面。
断行还与较新的几类内容相互影响。资源浮动体占据一栏或一页顶部或底部的一条区域,从而缩短栏的长度,而段首孤行、段末孤行和空余量惩罚值依据的正是这个长度。题注和表格单元格用题注字体和表格字体,作为自动换行的富文本测量。行间数学公式居中且不可分割,从不两端对齐,也从不断开。详见文档格式 › 资源以及配置 › 表格样式 / 题注样式。
回退行为:如果Knuth-Plass找不到有效的断点(栏极窄或词极长时可能出现),引擎会回退到Pretext的贪心layoutNextLine()。这样排版总能完成。
#断词
断词与两端对齐密不可分。没有断词,引擎避免松散行的唯一办法就是把一个词移到下一行,而这往往只是把问题挪了个地方。断词给引擎提供了多得多的候选断点,大大提高两端对齐文本的质量。
#TeX品质的断词模式
Postext用Hypher(hypher v0.2.5)断词,背后是TeX/Liang断词模式。这与TeX自1983年起使用的模式相同:Frank Liang的模式生成算法从大型词语语料中归纳出音节边界规则,并以紧凑的形式表示。
这些模式编码了一组带编号的规则,叠加到一个词上时,奇数表示允许断开,偶数表示禁止断开。每种语言模式文件中的leftmin和rightmin参数保证任何断点前后都至少有一定数量的字符。英语(en-us)通常分别为2和3,即连字符前至少2个字符,之后至少3个。
#支持的语言
| 语言代码 | 语言 |
|---|---|
'en-us' | 英语(美国) |
'es' | 西班牙语 |
'fr' | 法语 |
'de' | 德语 |
'it' | 意大利语 |
'pt' | 葡萄牙语 |
'ca' | 加泰罗尼亚语 |
'nl' | 荷兰语 |
每种语言加载各自的模式集。Hypher实例按需创建并缓存:某种语言的第一次调用承担初始化开销,之后的调用即刻返回。带地区子标签的语言标签使用其语言的模式('es-ES'按'es'断词,'en-GB'按'en-us')。这里没有模式的语言回退到en-us,引擎会在控制台警告一次(见配置参考中的断词)。中文、日文和韩文例外:它们不断词,也不发出警告,行在字与字之间断开(见下文中文、日文和韩文)。
加泰罗尼亚语遵循加泰罗尼亚研究院(IEC)《Llibre d'estil》第六章的规则,自postext 1.14起生效:
- 断点两侧至少各留两个字母(
ter-ra、cai-xa、plu-ja)。 - 双写的ela geminada在两个l之间断开,连字符取代中间的间隔点:il·lusió断为
il-|lusió。该行按去掉间隔点后的宽度测量,两端对齐和Knuth–Plass算法看到的是实际宽度。 - 构成元音分立(hiatus)的两个元音不拆开(
cièn-cia、ca-mions)。夹在元音之间的i或u视为辅音,归入下一个音节(fe-ia、ve-ient)。 - 撇号之后不立即断开(
s'ha-via,而不是s'-havia)。英语、法语和意大利语的撇号另有规则(见断词)。 - 常见的带前缀词在前缀处断开(
vos-altres、cel-obert、ben-estar)。 - IEC建议,带后附代词的词只在自身的连字符处断开(
portar-|lo);如要照此处理,把hyphenation.compounds设为false。
#为什么选Hypher(而不是自定义算法)
Postext最初的断词系统用的是一种基于元音的自定义启发式方法:通过查找元音组合、常见前缀(over-、under-、inter-)和常见后缀(-tion、-ment、-sion)来判断音节边界。它简单、快速,但有根本局限:
| 方面 | 自定义启发式方法 | Hypher(TeX模式) |
|---|---|---|
| 准确性 | 常见词表现不错,少见词不可靠。元音检测会漏掉许多有效断点,还会造出无效断点。 | 接近完美。模式从大型语料生成,并经过40多年的改进。 |
| 语言覆盖 | 每种语言都要手工定义元音集、前缀和后缀,繁琐且容易出错。 | 50多种语言都有模式文件,由TeX社区维护。增加一种语言只需多一条import。 |
| 行业标准 | 不是公认的标准,没有工具或社区支持。 | TeX、LibreOffice、Firefox、Chrome以及几乎所有专业排版系统都用同样的模式。 |
| 维护 | 每个边缘情况都是一个要手工修复的bug。 | 模式文件由社区维护,修复来自上游。 |
| 包体积 | 约170行,无依赖。 | Hypher核心约3 KB。每个语言模式文件增加20–80 KB(gzip后5–20 KB)。内置的全部8种语言的模式合计约300 KB(gzip后约80 KB)。 |
| 性能 | 很快(简单的字符串扫描)。 | 快(每个字符一次trie查找)。实际开销可以忽略,断词从来不是瓶颈。 |
取舍很清楚:包体积大一些,换来正确性的大幅提升,而且不用费力维护。对一个以出版级输出为目标的排版引擎,正确性优先。印刷成书的一处错误断词,代价比多出几KB模式文件高得多。
#断词如何与Knuth-Plass结合
文本进入Knuth-Plass算法之前,引擎先用Hypher预处理,在每个合法断点插入软连字符(Unicode \u00AD)。这些不可见字符随后映射为KP的惩罚值,代价为50,flagged: true。
算法把断词断点当作又一个选项,与自然的词边界(粘连处允许断开)一起评估。如果使用连字符得到的缺陷值总和比让这一行松散更低,算法就采用连字符;否则保留整个词。
连续连字符缺陷值(默认3000)使算法尽力避免相邻两行都以连字符结尾,几乎所有体例规范都要求这样做。
一栏或一页最后一行的连字符会让读者在词的中间跳到下一栏。bodyText.hyphenateAcrossColumns: false让这些行不带连字符:结束一栏的那一行以连字符结尾时,段落会重新断行,把那里的连字符按孤字计价;只要上面各行的词间距能在maxWordSpacing和minWordSpacing之内吸收差额,断行算法就会让那一行以完整的词结尾。吸收不了时,连字符保留。这项设置管的是段落的第一个跨栏断点,以及之后恰好落在整栏结束处的断点。之后落在别处的断点(为避开段首孤行而提前截短的栏、截平的收尾区域)会从那一栏开始再做一次重新断行:前面各栏已排好的行保留原断点,只有段落的其余部分重新断行。这样,只有在限度之内怎么排都避不开时连字符才会保留,实际上就是在段落的第一个跨栏断点处。hyphenateAcrossColumns: 'withinPage'只对结束一页的那些行保留这种保护:翻页的读者,或者把目光移到对页的读者,遇到的是完整的词;而断在同一页两栏之间的词则允许出现。三栏版式下,每三个栏尾就有两个不受保护,于是需要重新断行的段落更少,为此放宽或收紧词间距的行也更少。断行算法只在它所保护的最后一行之前区分到达某一行的不同路径,所以一次重试的开销与第一次测量相当:每重新断行一个段落,就多做一次测量。
默认情况下,只有bodyText.hyphenation.enabled为true并且bodyText.textAlign为'justify'时才断词:不对齐的那一边本来就该有长有短。齐左文本也可以断词,设置bodyText.hyphenation.ragged: true即可。齐左的行没有词间距需要匀开,因此由断词区来决定:放不下的词,只有在整个移到下一行会留下宽于hyphenation.zone(默认3 em)的空隙时才断开。齐左的正文也由Knuth-Plass排(bodyText.optimalRagged,默认开启):词间空格保持宽度,每一行按它比行长短多少计价,由断词区决定它可以取哪些音节;连续两行以音节结尾要计连续连字符缺陷值。逐行排时(optimalRagged: false),以音节结尾的行不会连续超过两行。见齐左文本。
有两种断点与这项设置无关。一是两个字母之间的硬连字符,如enseñanza-aprendizaje、físico-química,行可以在这里结束:词本来就带着连字符,所以不再添加。启用bodyText.breakAfterHyphens(默认开启)时,Knuth-Plass在每个段落中都会采用它,计价与音节相同;在不带行内格式的两端对齐段落中,只有连字符两边各有两个字母时才采用,所以不会有一行结束在e-mail的e-上。关闭它时(与postext 1.4及以前一样),不带行内格式的两端对齐段落不会紧接这种连字符断开,而同一段落里只要任意一个词是斜体就会断开;postext 1.5之前保存的书读入时这项设置为关闭。行结束在文本自带的连字符上,该行会在hyphenated之外记录hardHyphen,所以那些会去掉引擎所加连字符的地方(书眉、沙盒的光标)仍会保留这个连字符。二是两个词之间紧排的破折号或连接号,如say—that’s、riddles.—I、Hamburg–Berlin,启用bodyText.breakAfterDashes(默认开启)时,两种断行算法都可以在这里结束一行:行结束在破折号上,不添加任何东西,也不计任何代价。一个样式片段末尾的破折号后面紧跟另一样式的词(see—*and*)时也一样。此时该行记为hyphenated,不带hardHyphen。以下情况从不在破折号后断开:破折号引出插入语或一行对白时(—dijo、said "—Hola;结束一个词的引号可以位于破折号之前,如"no"—and或德语的„nein“—und),破折号后面是标点、引号或括号时(thinking—" and、says—“no”),在连续的破折号之中,或在数字范围之中(1914–1918)。此外,比整个行长还宽的词(窄表格单元格、窄栏中的长复合词)绝不会越出行长:引擎在放得下的最后一个音节处加连字符断开;词典在那里没有音节可断时,就在放得下的最后一个字符处断开;如果断点紧挨着词本身带的连字符,就断在那个连字符之后,不再添加,所以词里不会出现两个连字符。词的其余部分保留自身的断点:复合词继续在连字符处断开,网址在各个连接处断开;postext 1.4及以前,其余部分按词典的音节划分。不带行内格式的段落,除非启用了断词,否则在放得下的最后一个字符处截断,不加连字符。含有这种词时,Knuth-Plass找不到任何可行的断点组合,所以含有它的两端对齐段落改为逐行排。数字是例外(postext 1.82起):见下文的数字内部。
这样的截断会被报告(postext 1.52起):在两个字母之间截断的词报告为wordDividedByCharacter警告,在音节处断开的词报告为wordDividedBySyllable提示,并附上该行文字。该行把它记录在wordDivided中('character'或'syllable')。书眉、开篇设计和组版页面的框中也是如此,常见原因是框太窄:请给文字更多空间或缩小字号。在不换行空格处断开不会拆分任何词,不会报告。
两个词之间的斜杠(input/output、ACC/AHA/AAPA)也是带格式文字可以断行的地方,由bodyText.breakAfterSlashes控制(自postext 1.53起默认开启):行在斜杠处结束,下一行从斜杠后的词开始,不添加任何字符,也不计代价。斜杠两边各须至少有三个连续的字母或数字,且不能两边都是数字,所以单位(km/h、kg/m³、mg/dL)、短词组(and/or)、分数和日期(1/2、10/03/2026)保持完整。比整个行宽还宽的词,先在斜杠后拆开,再考虑音节或字母之间;网址中的//除外,任何斜杠后都可以,这种拆分不报告。文中输入的零宽空格(U+200B)同样是断点:行可以在那里结束,不添加任何字符,这个字符也不会进入行的文字。没有行内格式的段落,无论这项设置如何,都会在断词词典标出的任何斜杠后断行。configVersion 19之前保存的配置以breakAfterSlashes: false读取,即postext 1.51的断行:带格式的行只在网址里的斜杠后断开。
#复合词
用连字符连接的复合词(after-dinner、teórico-práctico)可以在两类位置断开:自带的连字符之后,以及任一部分内部的词典音节处(af-ter-dinner)。TeX和《芝加哥格式手册》都让各部分保持完整,只在连字符处断开复合词。bodyText.hyphenation.compounds: false也这样做:词典不处理任何在两个字母之间带连字符的词,所以它只在那个连字符之后断开。词里两个字母之间手动输入的软连字符照样可以断开,比整行还宽的复合词在必要时也照样会被划分。默认值true继续划分各部分,让两端对齐的窄栏有更多办法填满各行。
葡萄牙语正字法要求,复合词在行末断开时,连字符要在下一行开头重复(vencer- · -se);西班牙皇家学院自2010年起的规则也这样要求(léxico- · -semántico),好让读者知道连字符属于这个词。bodyText.repeatHyphen: true实现这一点。重复的连字符与所在行一起测量,所以断行算法会为它留出位置,它也与其余文本一样绘制;在PDF中,它带有一段略去它的替代文本,所以从PDF复制或提取的文本中这个词只出现一次(vencer-se)。该行把它记录为repeatedHyphen,其plainStart和sourceStart指向它之后,所以源映射、链接和书眉读到的是这个词的原样写法。网址从不重复连字符。这项设置适用于正文、标题、列表、引文块和标注框;含有复合词的无格式段落此时改由排带格式文本的断行算法断行。
#不拆分的词
可以让词典不去处理某些词。bodyText.hyphenation.exceptions逐个列出这些词:'Alice'绝不划分,'You-Tube'只在条目中的连字符处划分,相当于TeX的\hyphenation{…}。bodyText.hyphenation.capitalized: false让所有以大写字母开头的词保持完整,citations.hyphenateNames: false则让文档所引作者的姓氏保持完整。这样一来,断行算法可以结束一行的位置就少了:原先某个名字被划分的地方,前一行改为增大或缩小词间距,范围不超出minWordSpacing和maxWordSpacing。比整个行长还宽的词照样划分。条目如何匹配,见不拆分的词。
#行从不断开的地方
有些位置在两种断行算法中都不能断开:
- 不换行空格。 U+00A0、窄不换行空格U+202F和数字空格U+2007把两边的词粘在一起:数字和单位、页码引用、千位分组。题注、表格单元格、标注框和版面设计文本(书眉、章首页)中也一样。每种空格都保留测量得到的自身宽度;两端对齐只拉伸词间空格。字体中没有U+202F或U+2007字形时,所有输出(包括PDF)都采用浏览器给它们的宽度,分别为半个词间空格和一个数字宽;几乎每种字体都有U+00A0。用这种方式粘在一起的一组文字如果比整行还宽,则是例外,无论有无行内格式:它在最后一个不换行空格处断开,而不是在某个词内部截断。词连接符U+2060只粘连、不占位置,在中文文本中也一样:中间夹着词连接符的两个字会留在同一行。(①这样的带圈数字不需要它:自postext 1.25起,中文文本会让它与后面的字留在同一行。)U+FEFF(零宽不换行空格)也是如此,不过专门用于此的字符是词连接符。
- 带编号的引用文字。 印出编号或页码的行内引用(
section 3.2、p. 112、Fig. 1.7、Theorem 2)是一个词:不论模板里用的是哪种空格,行都不会在词和编号之间断开,这个空格也不拉伸。以文字印出的引用(锚点的文字、标题、自定的text="…")自postext 1.28起不同:它在自己的空格处断开,这些空格随行拉伸(crossRefs.breakLabels);其中的词仍然从不断词。 - 紧贴的文本。 粗体或斜体词及其后的标点(
**osmosis**.)、行内引用两侧的括号((:ref{id="fig-3"}))、分成两个片段排的一个词:中间没有空格的文本是一个单位,如同一个词。这样的单位放不进一行剩下的空间时,整体移到下一行。它位于行首仍放不下时,其最后一个词在某个音节处断开,让标点随词尾一起下移;只有无音节可断的单位才会让标点出现在下一行开头。 - 一侧没有字母的软连字符处。 文本中输入的软连字符(U+00AD)只有夹在两个字母或数字之间才是断点:输入在
to和gether之间时,行可以结束在to-上。输入在词的边缘、左括号或前引号之后、结束标点之前时,它既不断开也不印出任何东西,所以不会有哪一行在完整的词后面以连字符结束。又因为词典不处理已经带有软连字符的词,输入在首字母之前的软连字符会让这一处的词保持完整,任何语言都一样:A前面有一个软连字符时,Alice绝不会被划分。InDesign的自由连字符就是这样写的,从它导出的文本保留了这层含义。postext 1.27及以前,这样的软连字符与其他断点无异(said Alice-),在加泰罗尼亚语下,词的其余部分仍会被划分。 - 数字内部。 数字从不像词那样被划分,既不在音节处断开,也不在两个数字之间断开(postext 1.82起):
3,60-排在0的上一行,读起来像两个数。数字是以数字开头的词,前面可以有左括号或前引号、正负号或货币符号,其中只含数字(任何文字的数字)以及用来分组和分隔的符号(.,'’、不换行空格、窄不换行空格和细空格、阿拉伯文分隔符),后面可以带指数、直接相连或以不换行空格相连的单位(kg、km/h、°C、%、1990s的s)和结束标点:3,600、−12.5、(€1,250.00)、37 °C。日期或范围(2026-11-13、1914–1918)以及第一个数字前有字母的词(COVID-19)都不是数字。比所在行还宽的数字,通常出现在窄表格列、题注或附注中,无论文本是否断词,都整体超出行长,排版时给出numberOverflow内容警告,注明该数字;在题注、附注或表格单元格中,还注明资源及其所在部分(单元格的行和列)。数字只在各组之间的不换行空格处分开,那里不添加任何东西:用U+202F或U+00A0写4 356 000,长数字就能转到下一行。否则请加宽该列(提高它在columnWidths中的权重)或缩小字号。postext 1.81及以前,这样的数字会按字符截断并加上连字符(3,60-|0),报告为wordDividedByCharacter。 - 连写文字的词内部。 阿拉伯文(以及叙利亚文、N'Ko文、蒙古文)的单词从不断词,即使词中写了软连字符也不断,也从不在字母之间截断:这些字母彼此相连,单独排出的片段会变成别的字形和宽度。阿拉伯语和其他从右到左的语言默认关闭断词;打开断词时(为阿拉伯文书中的拉丁词,或在引用阿拉伯文的英文书中),词典会跳过这类单词。分成两种样式的单词(
كتا**ب**)仍是一个词,按整体测量。比整行还宽的这类单词会超出行长,排版时给出unbreakableWordOverflow内容警告。
postext 1.4及以前,带行内格式或:ref的段落可能在不换行空格处断开,齐左的行也可能结束在引用前的(上,或以粗体词后的句号开头。
#词间距上下限
粘连模型为引擎明确规定了词间空格可以伸缩的范围。这一范围由bodyText上的两个配置属性控制:
| 属性 | 默认值 | 说明 |
|---|---|---|
maxWordSpacing | 2 | 词间距上限,以正常空格宽度的倍数表示。取默认值时,空格最多可以伸展到自然宽度的200%。 |
minWordSpacing | 0.6 | 词间距下限,以正常空格宽度的倍数表示。取默认值时,空格最多可以收缩到自然宽度的60%。 |
这两个倍数直接换算为Knuth-Plass模型中粘连的stretch和shrink值:
stretchPerSpace = normalSpaceWidth × (maxWordSpacing - 1)
shrinkPerSpace  = normalSpaceWidth × (1 - minWordSpacing)
取默认值(2 / 0.6)时,如果正常空格宽度为4 px:
- 每个空格可以伸展4 px(从4 px到8 px)
- 每个空格可以收缩1.6 px(从4 px到2.4 px)
更窄的范围(如maxWordSpacing: 1.2)使间距更均匀,但给算法留的回旋余地更小,可能导致更多断词,极端情况下甚至超出行长。更宽的范围(如maxWordSpacing: 2.5)给算法更大的灵活性,但有些行的间距会明显不匀。
默认值2和0.6偏向算法的灵活性:让Knuth-Plass在窄栏中有足够余地避免超出行长、断词和孤字,同时仍稳稳处在排版文献认为可以接受的范围内。
#断行算法填不满的行
Knuth-Plass在有选择时不会把一行拉伸到超过maxWordSpacing,孤字修正也不会(见段首孤行、段末孤行和孤字惩罚值)。一行一旦超过上限,它的代价就比算法权衡的其他任何缺陷都高,无论是一个连字符、一个短末行,还是比邻行稍松的一行;此后代价还随伸缩比的平方增长。所以断行算法宁可断开一个词、把空余量分摊到周围各行,或者让两行都稍松,也不让一行松得太多。
有时没有任何断点组合能留在范围之内。放不下下一个词的那一行,空格太少,分摊不了空余量:段首缩进下的第一行,后面跟着一个太长而上不来、又太短而无法断词的词;一行由不可断开的长术语组成;一个只能在自身连接处断开的长网址;一个列表项,它的最后一个词上不来,而任何断词都会留下孤字。这种情况出现得多频繁,取决于行长、字体和语言。在83 mm宽、排9.3 pt英文的栏里,一章中有2%到8%的行超过了maxWordSpacing,因字体而异(字面最宽的最多);同一章的西班牙语版本断词机会多得多,一行也没有。这时Knuth-Plass接受最不坏的一行,它的空格拉伸超过上限。当空格会拉伸到正常空格宽度的3倍以上时,引擎改为把这一行排成齐左:按自然间距绘制,右边不齐,就像段落的末行。这个阈值与沙盒的松散行警告所用的阈值相同。这样的行按齐左排出,同时会被报告:内容警告raggedLine带有该行的文字、所在页和撑满行长本来需要的倍数(在沙盒里是排版类警告中的两端对齐的行未撑满,点击即选中该行),VDTLine.raggedSpaceRatio则把这个倍数记在行上。改一改措辞,或者给这一行一个可以断开的位置。在阈值之内的行按测量结果保留。标注框内部也是如此,它们的行长窄,这种情况最常见;postext 1.4及以前,标注框无论空格拉伸多宽都让这样的行保持两端对齐。
在窄栏里,这多半是短段落的首行:首行缩进让它只剩几个空格,后面又跟着一个单音节词或一个前引号(「„Beim Schwärmen stechen sie」+「nicht.」)。引擎不会为了这一行而收回缩进:缩进在段与段之间忽有忽无,整栏看上去都是毛病,而一行短行不会。在60 mm和92 mm宽的德文杂志栏里,maxJustifyTracking: 12(见下文)把超过2×的行从8.8%降到4.0%;剩下的只能靠改文字解决。
要减少这种行,按以下顺序尝试:检查断词是否开启并设为文本的语言;加大行长或减小字号;让这些行带一点字距(见下一节);或者提高maxWordSpacing,这会让同样的行算作在上限之内,但排法不变。
#最后手段:字距
bodyText.maxJustifyTracking让这样的行带一点字距(字母间距),而不是再加宽词间空格;每个字符的字距最多为该值个千分之一em(10 = 0.01 em,即InDesign的单位)。它双向起作用:空格会拉伸超过maxWordSpacing的行把字母拉开,直到空格回到上限;只有把空格压到minWordSpacing以下才放得下的行则收紧字母,而不是把一个词挪到下一行。Knuth-Plass在选择断点时就把它考虑进去:带字距的行比在范围之内的行代价略高,比超出范围的行代价低得多,所以只在单靠词间距行不通的地方才用字距。在范围之内的行、段落的末行(除非它超出行长)、只有一个词的行以及含有行内标签的行都不带字距。该行把它记录为VDTLine.letterSpacing,叠加在所在块自身的字距之上,Canvas、HTML和PDF都会绘制它。连写文字(阿拉伯文等)的词从不加字距,无论是这里的字距还是其他字距(样式的letterSpacing、各栏齐底、孤字修正):拉开字母会破坏连写。计算行的字距时不计这些字母,各输出也按无字距绘制它们;对这类文字设置letterSpacing的样式会得到joiningScriptLetterSpacing内容警告。
bodyText: {
  maxWordSpacing: 2,
  maxJustifyTracking: 10, // 每个字母最多0.01 em,收紧或拉开均可
}它默认关闭,文档不主动开启,各行就保持原样。在上文的英文章节中,10‰把超过maxWordSpacing的行减少到每种字体一行或零行,20‰则让四种字体中的三种降为零行。数值宜小:超过20‰左右,字距就会显现为一行颜色偏浅或偏深。
#阿拉伯文的卡希达
两端对齐的阿拉伯文行不加字距:字母彼此相连,拉开就会断开连笔。它在两处拉伸:词间空格和卡希达(kashida),即书法家在两个相连字母之间拉长的连笔(كتاب → كتـاب)。Postext以整个延长符(tatweel,U+0640,ـ)插入它们,由字体画成一笔;Amiri会把一到七个连续的延长符变成一条弧形的卡希达。
在用阿拉伯字母书写的语言(ar、fa、ur……)的文档中,bodyText.kashida默认为'auto',其他文档中为'none';想在其他语言的书中拉长引用的阿拉伯词,就设为'auto'。除段落最后一行外,每一行先把词间空格最多放宽其宽度的四分之一,余下的空白由卡希达承担:每次加一个延长符,先加在最好的位置,一轮接一轮,每加一次都把整个词连同延长符重新量一遍;剩下不足一个延长符的部分再交给空格。Knuth-Plass把每个词可拉长的量算作伸展量,所以它在选择断点时就知道一行阿拉伯词能在那里拉宽。
卡希达能放在哪里,依据的是raqim-kashida(MIT)的规则:只放在两个相连的字母之间,绝不放在不向后连的字母(ا د ذ ر ز و ة)之后,绝不放在词尾,绝不放在lām-alif之内,且总在前一个字母的符号之后。kashidaPatterns: 'naskh'遵循古典纳斯赫体的规则(Benatia的矩阵加上Afifi的禁例:kāf和lām之后不拉,ṣād、ʿayn、wāw之前不拉,词尾代词hāʾ就在它之前拉);'simple'是微软为简单的现代字体定的优先级;'nastaliq'是为波斯体(Nastaʿlīq)调整过的纳斯赫规则。默认值'auto'看正文字体:Aref Ruqaa这类鲁格阿体或迪瓦尼体不加卡希达,波斯体字体用nastaliq规则,其他用naskh。一个词最多拉kashidaPerWord处(默认1处),每处最长kashidaMaxLength个em(默认0.6,即Amiri的三个延长符)。作者自己输入了延长符的词,就在那里拉长。拉丁词、数字、标题、齐左的行和段落最后一行一律不加。
bodyText: {
  kashida: 'auto',          // 阿拉伯文书的默认值
  kashidaPatterns: 'naskh', // 'auto'按字体选择
  kashidaMaxLength: 0.6,    // em
}延长符是绘制出的文字的一部分(每个片段在VDTLineSegment.kashida中列出它们,行在VDTLine.kashida中计数);纯文本、源映射、链接以及从PDF复制的文字都不包含它们。
#末行
在盒子–粘连–惩罚值模型中,每个段落都以一个宽度为0、可无限伸展的粘连加一个强制断点结束。这个末尾粘连以零代价吸收末行剩下的所有空间,所以末行自然是右边不齐的:它们按自然宽度渲染,justifiedSpaceRatio也只对非末行计算。
有一个例外。Knuth-Plass可能接受一个自然内容宽于行长的末行,前提是它的词间粘连会收缩,这是TeX粘连设置的标准语义。三个后端都会检测这种情况(该行内容的自然宽度超过有效行长),并压缩末行的词间空格,使它恰好等于行长,而不是超出行长。Canvas、PDF和HTML后端采用完全相同的检查。
#最优断行与贪心断行
bodyText.optimalLineBreaking属性(默认:true)控制引擎使用哪种断行算法:
true:Knuth-Plass动态规划算法。评估所有可能的断点组合,选出全局最优的一组。所有两端对齐文本都推荐这项设置。启用bodyText.optimalRagged(默认开启)时,齐左的正文也用它:词间空格保持宽度,断行算法改为权衡每一行比行长短多少,短3 em的一行与词间距达到maxWordSpacing的两端对齐行代价相当,因此不齐的一边更均匀,孤字规则也适用。false:贪心首次适配,由Pretext的layoutNextLine()实现。更快,但效果较差。只在性能比排版质量更重要时使用(例如字符数极多时的实时预览)。
Knuth-Plass启用却找不到有效断点时(栏极窄或词比栏还宽时可能出现),引擎会对该段落自动回退到贪心断行。
#含制表符的行
含有制表符的段落(见文档格式 › 制表符与制表位)逐行排,与文字处理软件和InDesign排含制表符文字的方式相同;不论optimalLineBreaking如何设置,都不用Knuth-Plass。制表符落在哪里,取决于它所在的行已经排到了哪里,而最优搜索把各候选行的宽度当作互不相关来累加。中文和日文也是如此:含有制表符的段落按文档的断行规则在字与字之间断开,不做标点挤压,也不在字与字之间分配空白来两端对齐。
在两端对齐的段落中,含有制表符的行在最后一个制表符之前不拉伸,因为制表位决定了行中每一部分的起点。只有最后一个制表符之后的词间空格分担多余的空白,而且只在该行不是段落末行时才这样;最后一个制表符之后没有词间空格的行按排出的样子保留。不两端对齐的行不受影响。行会记录它含有制表符(VDTLine.tabbed);每个制表符是一个携带其制表位的空格片段(VDTLineSegment.tab),每个前导符是一个单独的片段(VDTLineSegment.leader,取'text'或'rule')。
各栏齐底从不把这样的段落重新排松,也从不给它加字距:它保持测量时的样子,制表位不会移动。
#中文、日文和韩文
CJK字符多于词间空格的段落由CJK排版器排,不用Knuth-Plass。两个字之间的每个间隙都可以断行(cjk.lineBreak的避头尾规则禁止之处除外),所以没有什么需要最优搜索去权衡;各行依次填满。一个字放不下时,这一行先尝试让出标点的空白(标点所占字格中的空白部分)和空格,把它容纳进来(挤进:词间空格最少压到四分之一em,然后是间隔号、括号、顿号,中西文间距最少压到八分之一em,再是句末点号,以cjk.punctuationWidth允许的程度为限);只有这样还不够时,不能出现在行首的字才把前一个字一起带到下一行。规则见东亚排版。中文版式介绍中文排版的其余部分:各地区的标点宽度、字符网格和竖排。日文文档则遵循JLReq(见日文排版):它有自己的禁则级别;一行按JLReq §3.8.3的顺序让出空白(首先是行末标点后的半个字宽,要么全部让出,要么完全不让;行内“。”之后的空白从不缩减);一行匀开时,前括号之后、后括号之前以及、。・:;?!旁边都不加空白。
这种段落中两端对齐的行(末行除外),按clreq规定的顺序(§6.2.2.4)匀开到行长:
- 西文词之间的空格,平均分配,每个最多半个em。
- 中西文之间的空格(
cjk.latinSpacing),平均分配,每个最多半个em。 - 字与字之间的每个间隙,平均分配,中西文间距也包括在内:汉字之间、汉字与标点之间、汉字与西文词之间。从不在西文词、数字、两字长的破折号或省略号内部,也从不在连接号(~、–、单个—)或斜线旁边。悬挂到行末之外的标点(
cjk.hangingPunctuation)不计入行长。
段落末行按原样排,不加间距。间距按行的片段记录(VDTLineSegment.tracking),所以Canvas、HTML和PDF绘制的位置相同,沙盒也能把光标放在点击的那个字上。
一行需要在字与字之间加超过半个em(设置了bodyText.maxJustifyTracking时,则是超过该值)才能排满时,就按这个上限排,不到行长,并报告一条cjkLooseLine内容警告(在沙盒中为CJK行排不满)。常见原因是一个长西文词或网址无法提到这一行。行中没有CJK字符时,比如长网址的开头部分,就排成齐左,不发出警告。
在松散行高亮中,CJK行按其间距判断是否松散:比值为1加上以八分之一em为单位的间距,所以在默认阈值3下,字间距超过四分之一em的行会被标出(lineLooseness(line, fontSizePx)给出这个比值)。各栏齐底可以把CJK段落多排一行:它把各行断得比行长略短,每次短八分之一em,最多两个em,再把它们匀开到行长。在字符网格上,两个字之间匀开的量不能超过headings.balancing.maxTracking,这样每个字都留在自己的格子里(见纵向两端对齐:各栏齐底)。
#松散行调试
即使有Knuth-Plass和断词,有些行仍会比理想状态松,尤其是在含长词的窄栏中,或断词机会少的语言中。调试功能松散行高亮帮你立刻找到这些问题行。
#工作原理
虚拟文档树中每个两端对齐的行都带有justifiedSpaceRatio:空格绘制的宽度与正体空格宽度之比。值为1.0表示正体空格的宽度;值为2.5表示空格是它的2.5倍宽。含有其他字体空格的行(一个斜体短语、一个粗体词)还带有第二个数justifiedSpaceLimitRatio,即minWordSpacing和maxWordSpacing所约束的词间距。lineWordSpacing(line)给出用来和上下限比较的数:行上有第二个数就取第二个,否则取第一个。
debug.looseLineHighlight.enabled为true时,沙盒在其Canvas预览上为每个词间距(lineWordSpacing)超过所设threshold的行绘制一层半透明覆盖层。正好排在maxWordSpacing上、又含有粗体空格的行,绘制出来会超出百分之几个空格宽度,但不计入:断行算法守住了上限。默认阈值为3.0,即只高亮空格比正常宽三倍的行。这条线有意定得很高;松到这个程度的行是真正的排版问题。引擎也以这个宽度为界:超过它,就不再拉伸两端对齐的行,而是改排为齐左(见断行算法填不满的行),所以取默认值时,高亮和looseLines警告在正文里几乎找不到什么:这样的行改按齐左排出,并作为raggedLine警告报告。把阈值降到1.5或2,可以找出松散但仍两端对齐的行。
覆盖层不属于页面,所以导出的页面上从不出现。要在你自己的Canvas上绘制它,在renderPageToCanvas之后紧接着调用drawLooseLines(ctx, page, doc, { threshold });findLooseLines(doc, { threshold })以数据形式返回同样的行(见在你自己的Canvas中标出松散行)。
#配置
松散行高亮属于PostextConfig的debug部分:
| 属性 | 类型 | 默认值 | 说明 |
|---|---|---|---|
looseLineHighlight. | boolean | false | 是否高亮松散行。 |
looseLineHighlight.color | ColorValue | #ff000040 | 高亮覆盖层的颜色。默认为半透明红色。 |
looseLineHighlight. | number | 3 | 正常空格宽度的倍数,超过它的行视为松散。值越小,找出的行越多;值越大,只高亮最严重的行。取3或以上时,正文里几乎什么也不显示,因为超过3倍的行已排成齐左。 |
debug: {
  looseLineHighlight: {
    enabled: true,
    threshold: 2.5,
    color: { hex: '#ff660040', model: 'hex' },
  },
}#解读结果
启用松散行高亮后,如果某些行上出现红色色带,说明引擎无法在词间距不过宽的前提下排出这些行。从上往下排查:原因按可能性从高到低排列。
| 原因 | 解决办法 |
|---|---|
| 栏宽相对字号太窄 | 加大栏宽、减小字号,或改为单栏版面。 |
| 长词的断词点少 | 确认断词已启用且语言设置正确。有些技术术语或专有名词没有有效断点。 |
| 断词被关闭 | 启用bodyText.。不断词的两端对齐几乎总是更差。 |
| 无论换什么字体,总有几行是松的 | 让这些行带一点字距:bodyText.。见最后手段:字距。 |
| 词间距范围太窄 | 稍微提高maxWordSpacing(例如从2提高到2.4),给算法更多余地。 |
| 语言有很长的复合词(如德语) | 确保语言设置正确。德语断词模式能很好地处理复合词,但前提是引擎知道文本是德语。 |
#纵向两端对齐:各栏齐底
Knuth-Plass解决的是横向问题:每一行在哪里断开。各栏齐底解决的是与之对应的纵向问题:每一栏在哪里结束。出版者要求一页中的每一栏都从页顶开始、与页面底部齐平,整个跨页逐行对齐。而保护文本质量的那些规则恰恰与此相悖:段首孤行与段末孤行保护、keepWithNext标题、不可拆分的图,都会在当前栏还没排满时就把内容推到下一栏,在栏底留下一条或多条空的基线网格行。
启用headings.balancing时(默认启用,竖排和字符网格除外),引擎会像排字工人那样补上这些空隙,按严格的编辑优先级依次使用各种手段;每种手段只处理前一种没能吸收的部分:
-
结束该栏的方框。 结束一个偏短栏的标注框按其底部下方的空余整体下移,使底边落在最后一条网格线上,与旁边的栏齐平;这段空余可以不足一行。这一手段最先执行,并占用全部空隙,除非
closingBox另有设定:'last'让下面几种手段先按整行占用,方框只取它们剩下的部分,这样为上方段落作注的方框仍能紧挨着它;'off'则从不移动方框。 -
有安全区的图片。 资源标出了安全区(
Resource.safeArea,任何时候都要显示的部分;见文档格式 › 安全区)的图片,以行内方式排在偏短栏中,或作为只占这一栏的浮动体排在栏顶或栏底时,按整条网格线增高:引擎保持图片宽度不变,裁去安全区以外的部分,让它变高。图片变高不会在页面上留下空洞,所以这一手段排在增加任何空白之前。在收尾的页面或区段上,各栏栏首要保持齐平,位于栏首的浮动体不会增高。 -
标题上方的间距。 给偏短栏中各标题的上外边距增加整条基线网格行。需要增加多行且该栏有多个标题时,这些行按标题的重要程度轮流分配,因此最重要的标题总是分得最多:分给一个
h2和一个h3的3行,变成h2上方+2行、h3上方+1行。位于栏顶的标题不会得到额外间距(各栏仍从页顶开始),栏末的标题也不会被推向栏底。一个标题这样最多先加maxLinesBeforeLoose行(默认两行),然后轮到后面的手段;只有它们再也补不了时,标题才继续加行,直到maxLinesPerHeading。 -
列表结束后的间距。 在列表或编号列表结束处增加一条网格行,列表后留出空白读起来很自然。每个列表末尾有上限(
maxLinesAfterList,默认为1)。其次,在行间公式或正文从其后接续的方框下方增加一条网格行(stretchAfterDisplays),在位于栏首的图或表下方也增加一条(stretchAfterFloats、maxLinesAfterFloat)。图下的文字可以是上一页起头的段落的剩余部分;它照样下移,下移的正是断行规则在栏底空出的那一行(段首孤行(widow)规则留空的一行,或者后面放不下文字的段间距)。图跨多栏时,只有图下各栏都加这一行(栏首因此保持平齐),或这一行正好补满该栏时才加(stretchAfterWideFloats)。 -
放松段落。 作为最后手段,把该栏中的段落重新断行,让它多出一行,即TeX的
\looseness=+1;最多处理maxLooseParagraphs个段落(默认两个),每段多一行。断行算法重新运行Knuth-Plass,要求恰好多出一行,并且只有当放松后的每一行都保持在maxWordSpacing以下时才接受结果:文字灰度绝不会超过你已经设定的上限。引擎优先选择该栏中最长的段落,多出的空白分摊到最多的词间空隙里,就看不出来了。此手段需要optimalLineBreaking(默认启用);跨栏拆开的段落不参与。被孤字修正缩短了一行的段落,从修正后的状态开始计算多出的那一行:它可以把修正拿掉的那一行要回来,但只能采用既没有孤字、也没有任何一行超过maxWordSpacing的断行方案(postext 1.4及之前,它可能带着一行远超上限的词间距回来)。仅靠词间距无法多出一行时,段落还可以采用少量正字距,这是排字工人的经典做法。引擎先试最小的量(先是
maxTracking的一半,再是maxTracking,单位为每字符千分之一em;默认为10,即0.01 em),保留第一个能多出一行的量,仍然受同样的词间距限制。字距在测量段落各行时计入,并由每种后端绘制(Canvas的letterSpacing、CSS的letter-spacing、PDF的字符间距)。设置trackParagraphs: false可将其关闭。
#为什么修正只影响局部
分栏的断点由元素决定:开启下一栏的元素之所以在那里,是因为它放不进空隙。因此,把一栏的尾部最多下移其自身空隙的高度,永远不会把内容挤进下一栏或下一页;每一栏都固定在原位,不会引发连锁的重排。引擎仍然会实际验证这一点:它用拟定的调整重新执行放置(最多8遍),测量剩余空隙的总量,并始终保留找到的最佳版面。放松后的段落如果无论用多少字距都无法在词间距上限内多出一行,就被列入黑名单,引擎转而尝试下一个候选段落。
#什么时候不处理偏短的栏
偏短的栏有时才是正确的输出,各栏齐底知道何时让开:
- 一页的最后一栏只有在该页自然流入下一页时才做齐底。由
:::pagebreak、标题的breakBefore或章首页结束的页面,保留偏短的最后一栏:一章本来就可以在页面中间结束。 - 文档的最后一页从不做齐底。
- 没有可用伸展点的栏(没有符合条件的标题、列表末尾或可放松的段落)保留空隙,而不去降低排版质量。
- 含有制表符的段落从不放松,也不加字距(见含制表符的行)。
const doc = buildDocument(content, {
  headings: {
    balancing: {
      enabled: true,            // 默认
      maxLinesPerHeading: 4,    // 每个标题的上限
      maxLinesBeforeLoose: 2,   // 先于其他手段的行数
      stretchAfterLists: true,  // 手段4
      maxLinesAfterList: 1,     // 每个列表末尾的上限
      stretchAfterDisplays: true, // 公式或方框之下
      looseParagraphs: true,    // 手段5,受bodyText.maxWordSpacing约束
      maxLooseParagraphs: 2,    // 每个偏短栏中放松的段落数
      trackParagraphs: true,    // 允许放松的段落采用少量字距
      maxTracking: 10,          // 每字符‰ em(0.01 em)
      closingBox: 'first',      // 手段1:'first' | 'last' | 'off'
    },
  },
});在沙盒中,这些选项位于版面设计 › 标题与目录的标题部分(“各栏齐底”,其下嵌套“列表后加行”“图下加行”“栏末方框”和“放松段落”)。打开基线网格(版面设计 › 高级 › 屏幕辅助),在Canvas视图中查看效果:关闭齐底时,偏短的栏结束在最后一条网格线上方;打开后,每个可以齐底的栏都结束在同一条线上。完整的选项说明见配置页面。
#完整示例
一份展示全部断词与两端对齐设置的完整配置:
import { buildDocument } from 'postext';

const vdt = buildDocument(content, {
  bodyText: {
    fontFamily: 'EB Garamond',
    fontSize: { value: 9, unit: 'pt' },
    textAlign: 'justify',

    // Knuth-Plass最优断行(默认:true)
    optimalLineBreaking: true,

    // 断词
    hyphenation: {
      enabled: true,
      locale: 'es',
    },

    // 词间距范围(正常空格宽度的倍数)
    maxWordSpacing: 2,     // 空格最多拉伸到200%
    minWordSpacing: 0.6,   // 空格最多压缩到60%
  },

  // 调试:高亮词间距过大的行
  debug: {
    looseLineHighlight: {
      enabled: true,
      threshold: 2.5,
      color: { hex: '#ff000040', model: 'hex' },
    },
  },
});#排版食谱中的示例
用到本页内容的食谱,每道列在最贴切的小节下。每道食谱都把页面和完整脚本并排展示。